
This page presents R code for implementing Bayesian conjugate models using standard prior–likelihood formulations and their associated posterior distributions.
- Binomial Beta model
- Poisson Gamma model
- Normal Normal model
- Normal Gamma model
- Normal Inverse gamma model
For preliminary theoretical part, refer
The choice of parameters should always follow the native argument convention of the corresponding R function. Several probability distributions, such as the Gamma distribution, permit alternative but equivalent parameterizations (e.g., shape–scale or shape–rate). Consequently, we should exercise appropriate care while specifying parameters to ensure consistency with the underlying R implementation.
The implementations use closed-form analytical expressions for posterior summaries wherever available, thereby avoiding numerical approximation except where necessary (e.g., posterior quantiles).
Numerical output includes posterior summaries such as the mean, median, and mode (where defined and computable), with user-selectable posterior quantiles and credible intervals of any desired probability level. Appropriate safeguards have been incorporated for cases in which the posterior mode does not exist or cannot be determined analytically.
Graphical output includes the corresponding prior and posterior density curves to facilitate visual comparison. All prior distribution parameters are fully user-configurable, allowing the models to be adapted to different prior beliefs and applications.
R code
Bayesian Conjugate Model – Binomial-Beta
Show code
# ========================================================================== # Bayesian Conjugate Model – Binomial-Beta # Closed-form analytical solution (standalone script) # # Likelihood : X | theta ~ Binomial(n, theta) # Prior : theta ~ Beta(alpha, beta) # Posterior : theta | x ~ Beta(alpha + x, beta + n – x) # # Input : scalar / vector OR data (df) + var + group_var # Output : clean console tables , ggplot, invisible list # ========================================================================== library(ggplot2) # ========================================================================== # INTERNAL UTILITIES # ========================================================================== # — console table — .print_table <- function(title, df) { col_names <- names(df) col_widths <- mapply(function(nm, col) { max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE)) }, col_names, df) col_widths <- pmax(col_widths, 10L) total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L divider <- paste(rep("=", total_width), collapse = "") thin_div <- paste(rep("-", total_width), collapse = "") header <- paste( mapply(formatC, col_names, width = col_widths, flag = "-"), collapse = " " ) lines <- character(0) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", title)) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", header)) lines <- c(lines, sprintf(" %s", thin_div)) for (i in seq_len(nrow(df))) { row_str <- paste( mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"), as.list(df[i, ]), col_widths), collapse = " " ) lines <- c(lines, sprintf(" %s", row_str)) } lines <- c(lines, divider) lines <- c(lines, "") writeLines(lines) } # --- Expand cri_levels to quantile vector --- .expand_cri <- function(cri_levels, quantiles) { q_all <- sort(unique(as.numeric(quantiles))) if (!is.null(cri_levels)) { cri_levels <- sort(unique(cri_levels)) tails <- as.vector(rbind((1 - cri_levels / 100) / 2, 1 - (1 - cri_levels / 100) / 2)) q_all <- sort(unique(c(q_all, tails))) } q_all } # --- Build CrI table (from cri_levels only - symmetric CrI pairs) --- .build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) { if (is.null(cri_levels)) return(NULL) rows <- list() for (lev in sort(unique(cri_levels))) { lo <- (1 - lev / 100) / 2 hi <- 1 - lo idx_lo <- which(abs(all_q - lo) < 1e-10) idx_hi <- which(abs(all_q - hi) < 1e-10) if (length(idx_lo) && length(idx_hi)) { rows[[length(rows) + 1L]] <- data.frame( Level = sprintf("%d%% %s", lev, cri_type), Lower = formatC(q_vals[idx_lo], format = "f", digits = 6), Upper = formatC(q_vals[idx_hi], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Build individual quantile table (from quantiles arg only) --- .build_quantile_table <- function(quantiles, all_q, q_vals) { if (is.null(quantiles) || length(quantiles) == 0L) return(NULL) rows <- list() for (q in sort(unique(quantiles))) { idx <- which(abs(all_q - q) < 1e-10) if (length(idx)) { rows[[length(rows) + 1L]] <- data.frame( Quantile = sprintf("Q(%.4f)", q), Value = formatC(q_vals[idx], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Validate data + var inputs (Binomial-Beta) --- .validate_df_var <- function(data, var) { if (!is.data.frame(data)) stop("`data` must be a data.frame") if (is.null(var) || length(var) != 1L || !is.character(var)) stop("`var` must be a single column name (character scalar)") if (!var %in% names(data)) stop(sprintf("Column '%s' not found in data", var)) col <- data[[var]] if (all(is.na(col))) stop(sprintf("Column '%s' is entirely NA", var)) uvals <- unique(na.omit(col)) if (length(uvals) > 2L) stop(sprintf( “Column ‘%s’ has %d unique values. Binomial model requires a binary variable (exactly 2 levels).”, var, length(uvals) )) if (length(uvals) < 2L) stop(sprintf("Column '%s' has only one unique non-NA value — cannot fit Binomial model", var)) invisible(TRUE) } # --- Validate group_var --- .validate_group <- function(data, group_var) { if (!is.null(group_var)) { if (!group_var %in% names(data)) stop(sprintf("group_var column '%s' not found in data", group_var)) } invisible(TRUE) } # --- Split data into entries by group --- .split_entries <- function(data, var, group_var) { if (!is.null(group_var)) { grps <- unique(data[[group_var]]) lapply(grps, function(g) { list(label = sprintf("%s = %s", group_var, as.character(g)), col = data[data[[group_var]] == g, var]) }) } else { list(list(label = "All", col = data[[var]])) } } # ========================================================================== # BINOMIAL - BETA # ========================================================================== conjugate_binomial_beta <- function( data = NULL, var = NULL, group_var = NULL, success_level = NULL, # which level counts as success; NULL = first level / 1 for 0-1 numeric x = NULL, # scalar or vector of success counts (no-data path) n = NULL, # scalar or vector of trials alpha, beta, cri_levels = c(90, 95), quantiles = NULL, cri_type = "CrI" ) { all_q <- .expand_cri(cri_levels, quantiles) # --- Build entries --- if (!is.null(data)) { .validate_df_var(data, var) .validate_group(data, group_var) entries_raw <- .split_entries(data, var, group_var) entries <- lapply(entries_raw, function(e) { col <- na.omit(e$col) uval <- sort(unique(col)) # determine success level sl <- if (!is.null(success_level)) { if (!success_level %in% uval) stop(sprintf("success_level '%s' not found in column '%s'", success_level, var)) success_level } else { uval[1L] # first level (alphabetically for character/factor, 0 for 0-1 numeric) } list(label = e$label, x = sum(col == sl), n = length(col), sl = sl) }) } else { if (is.null(x) || is.null(n)) stop("Provide `data` + `var` OR both `x` and `n`") x <- as.numeric(x) n <- as.numeric(n) if (length(n) == 1L) n <- rep(n, length(x)) if (length(x) != length(n)) stop("`x` and `n` must be the same length") entries <- lapply(seq_along(x), function(i) list(label = as.character(i), x = x[i], n = n[i], sl = "1")) } # --- Per-entry computation --- results <- lapply(entries, function(e) { xv <- e$x; nv <- e$n a_post <- alpha + xv b_post <- beta + (nv - xv) pr_mean <- alpha / (alpha + beta) pr_var <- (alpha * beta) / ((alpha + beta)^2 * (alpha + beta + 1)) pr_mode <- if (alpha > 1 && beta > 1) (alpha – 1) / (alpha + beta – 2) else NA_real_ pr_median <- qbeta(0.5, shape1 = alpha, shape2 = beta) po_mean <- a_post / (a_post + b_post) po_var <- (a_post * b_post) / ((a_post + b_post)^2 * (a_post + b_post + 1)) po_mode <- if (a_post > 1 && b_post > 1) (a_post – 1) / (a_post + b_post – 2) else NA_real_ po_median <- qbeta(0.5, shape1 = a_post, shape2 = b_post) all_q_int <- sort(unique(c(all_q, 0.5))) q_vals <- qbeta(all_q_int, shape1 = a_post, shape2 = b_post) .fmt_mode <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6)) .print_table( sprintf("Binomial-Beta | %s | Data Summary", e$label), data.frame( Successes = xv, Trials = nv, `Observed Prop` = formatC(xv / nv, format = "f", digits = 6), `Success Level` = as.character(e$sl), check.names = FALSE ) ) .print_table( sprintf("Binomial-Beta | %s | Parameters & Moments", e$label), data.frame( Quantity = c("alpha", "beta", "Mean", "Median", "Mode", "Variance", "SD"), Prior = c(formatC(alpha, format = "f", digits = 6), formatC(beta, format = "f", digits = 6), formatC(pr_mean, format = "f", digits = 6), formatC(pr_median,format = "f", digits = 6), .fmt_mode(pr_mode), formatC(pr_var, format = "f", digits = 6), formatC(sqrt(pr_var), format = "f", digits = 6)), Posterior = c(formatC(a_post, format = "f", digits = 6), formatC(b_post, format = "f", digits = 6), formatC(po_mean, format = "f", digits = 6), formatC(po_median,format = "f", digits = 6), .fmt_mode(po_mode), formatC(po_var, format = "f", digits = 6), formatC(sqrt(po_var), format = "f", digits = 6)), stringsAsFactors = FALSE ) ) cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type) if (!is.null(cri_df)) .print_table(sprintf("Binomial-Beta | %s | Credible Intervals (%s)", e$label, cri_type), cri_df) q_df <- .build_quantile_table(quantiles, all_q_int, q_vals) if (!is.null(q_df)) .print_table(sprintf("Binomial-Beta | %s | Posterior Quantiles", e$label), q_df) # boundary protection: avoid Inf at 0 and 1 when shape params < 1 th_lo <- if (min(alpha, beta, a_post, b_post) < 1) 1e-4 else 0 th_hi <- if (min(alpha, beta, a_post, b_post) < 1) 1 - 1e-4 else 1 th <- seq(th_lo, th_hi, length.out = 1000) dfp <- data.frame( theta = rep(th, 2), density = c(dbeta(th, alpha, beta), dbeta(th, a_post, b_post)), Distribution = factor(rep(c("Prior", "Posterior"), each = 1000), levels = c("Prior", "Posterior")) ) p <- ggplot(dfp, aes(x = theta, y = density)) + geom_line(colour = "#2C7BB6", linewidth = 0.9) + facet_wrap(~ Distribution, nrow = 1, scales = "free") + labs( title = sprintf("Binomial-Beta [%s]", e$label), subtitle = sprintf("Prior: Beta(%.2f, %.2f) | Posterior: Beta(%.2f, %.2f)", alpha, beta, a_post, b_post), x = expression(theta), y = "Density" ) + theme_bw(base_size = 13) + theme(strip.text = element_text(face = "bold")) print(p) invisible(list( label = e$label, data = list(x = xv, n = nv, success_level = e$sl), prior = list(alpha = alpha, beta = beta, mean = pr_mean, median = pr_median, mode = pr_mode, var = pr_var, sd = sqrt(pr_var)), posterior = list(alpha = a_post, beta = b_post, mean = po_mean, median = po_median, mode = po_mode, var = po_var, sd = sqrt(po_var), quantiles = setNames(q_vals, all_q_int)), plot = p )) }) invisible(if (length(results) == 1L) results[[1L]] else results) } # ========================================================================== # USAGE EXAMPLES # ========================================================================== # scalar # conjugate_binomial_beta(x = 14, n = 20, alpha = 2, beta = 2, # cri_levels = c(80, 90, 95, 99), quantiles = c(0.75)) # df + var (binary 0/1) # df <- data.frame(response = c(1,0,1,1,0,1,0,0,1,1)) # conjugate_binomial_beta(data = df, var = "response", # alpha = 2, beta = 2, cri_levels = c(90, 95)) # df + var (character binary) + group + success_level # df <- data.frame(response = c("Yes","No","Yes","Yes","No","Yes","No","No","Yes","Yes"), # group = rep(c("A","B"), each = 5)) # conjugate_binomial_beta(data = df, var = "response", group_var = "group", # success_level = "Yes", # alpha = 2, beta = 2, cri_levels = c(90, 95)) conjugate_binomial_beta(x = 14, n = 20, alpha = 2, beta = 2, cri_levels = c(80, 90, 95, 99), quantiles = c(0.75))
# ==========================================================================
# Bayesian Conjugate Model - Binomial-Beta
# Closed-form analytical solution (standalone script)
#
# Likelihood : X | theta ~ Binomial(n, theta)
# Prior      : theta ~ Beta(alpha, beta)
# Posterior  : theta | x ~ Beta(alpha + x, beta + n - x)
#
# Input  : scalar / vector  OR  data (df) + var + group_var
# Output : clean console tables , ggplot, invisible list
# ==========================================================================

library(ggplot2)

# ==========================================================================
# INTERNAL UTILITIES
# ==========================================================================

# --- console table ---
.print_table <- function(title, df) {
  col_names  <- names(df)
  col_widths <- mapply(function(nm, col) {
    max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE))
  }, col_names, df)
  col_widths <- pmax(col_widths, 10L)

  total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L
  divider     <- paste(rep("=", total_width), collapse = "")
  thin_div    <- paste(rep("-", total_width), collapse = "")

  header <- paste(
    mapply(formatC, col_names, width = col_widths, flag = "-"),
    collapse = "   "
  )

  lines <- character(0)
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", title))
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", header))
  lines <- c(lines, sprintf("  %s", thin_div))
  for (i in seq_len(nrow(df))) {
    row_str <- paste(
      mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"),
             as.list(df[i, ]), col_widths),
      collapse = "   "
    )
    lines <- c(lines, sprintf("  %s", row_str))
  }
  lines <- c(lines, divider)
  lines <- c(lines, "")
  writeLines(lines)
}

# --- Expand cri_levels to quantile vector ---
.expand_cri <- function(cri_levels, quantiles) {
  q_all <- sort(unique(as.numeric(quantiles)))
  if (!is.null(cri_levels)) {
    cri_levels <- sort(unique(cri_levels))
    tails      <- as.vector(rbind((1 - cri_levels / 100) / 2,
                                  1 - (1 - cri_levels / 100) / 2))
    q_all      <- sort(unique(c(q_all, tails)))
  }
  q_all
}

# --- Build CrI table (from cri_levels only - symmetric CrI pairs) ---
.build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) {
  if (is.null(cri_levels)) return(NULL)
  rows <- list()
  for (lev in sort(unique(cri_levels))) {
    lo     <- (1 - lev / 100) / 2
    hi     <- 1 - lo
    idx_lo <- which(abs(all_q - lo) < 1e-10)
    idx_hi <- which(abs(all_q - hi) < 1e-10)
    if (length(idx_lo) && length(idx_hi)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Level = sprintf("%d%% %s", lev, cri_type),
        Lower = formatC(q_vals[idx_lo], format = "f", digits = 6),
        Upper = formatC(q_vals[idx_hi], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Build individual quantile table (from quantiles arg only) ---
.build_quantile_table <- function(quantiles, all_q, q_vals) {
  if (is.null(quantiles) || length(quantiles) == 0L) return(NULL)
  rows <- list()
  for (q in sort(unique(quantiles))) {
    idx <- which(abs(all_q - q) < 1e-10)
    if (length(idx)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Quantile = sprintf("Q(%.4f)", q),
        Value    = formatC(q_vals[idx], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Validate data + var inputs (Binomial-Beta) ---
.validate_df_var <- function(data, var) {

  if (!is.data.frame(data))
    stop("`data` must be a data.frame")

  if (is.null(var) || length(var) != 1L || !is.character(var))
    stop("`var` must be a single column name (character scalar)")

  if (!var %in% names(data))
    stop(sprintf("Column '%s' not found in data", var))

  col <- data[[var]]

  if (all(is.na(col)))
    stop(sprintf("Column '%s' is entirely NA", var))

  uvals <- unique(na.omit(col))
  if (length(uvals) > 2L)
    stop(sprintf(
      "Column '%s' has %d unique values. Binomial model requires a binary variable (exactly 2 levels).",
      var, length(uvals)
    ))
  if (length(uvals) < 2L)
    stop(sprintf("Column '%s' has only one unique non-NA value — cannot fit Binomial model", var))

  invisible(TRUE)
}

# --- Validate group_var ---
.validate_group <- function(data, group_var) {
  if (!is.null(group_var)) {
    if (!group_var %in% names(data))
      stop(sprintf("group_var column '%s' not found in data", group_var))
  }
  invisible(TRUE)
}

# --- Split data into entries by group ---
.split_entries <- function(data, var, group_var) {
  if (!is.null(group_var)) {
    grps <- unique(data[[group_var]])
    lapply(grps, function(g) {
      list(label = sprintf("%s = %s", group_var, as.character(g)),
           col   = data[data[[group_var]] == g, var])
    })
  } else {
    list(list(label = "All", col = data[[var]]))
  }
}

# ==========================================================================
# BINOMIAL - BETA
# ==========================================================================

conjugate_binomial_beta <- function(
    data          = NULL,
    var           = NULL,
    group_var     = NULL,
    success_level = NULL,   # which level counts as success; NULL = first level / 1 for 0-1 numeric
    x             = NULL,   # scalar or vector of success counts (no-data path)
    n             = NULL,   # scalar or vector of trials
    alpha,
    beta,
    cri_levels    = c(90, 95),
    quantiles     = NULL,
    cri_type      = "CrI"
) {

  all_q <- .expand_cri(cri_levels, quantiles)

  # --- Build entries ---
  if (!is.null(data)) {
    .validate_df_var(data, var)
    .validate_group(data, group_var)
    entries_raw <- .split_entries(data, var, group_var)

    entries <- lapply(entries_raw, function(e) {
      col  <- na.omit(e$col)
      uval <- sort(unique(col))

      # determine success level
      sl <- if (!is.null(success_level)) {
        if (!success_level %in% uval)
          stop(sprintf("success_level '%s' not found in column '%s'", success_level, var))
        success_level
      } else {
        uval[1L]   # first level (alphabetically for character/factor, 0 for 0-1 numeric)
      }

      list(label = e$label,
           x     = sum(col == sl),
           n     = length(col),
           sl    = sl)
    })

  } else {
    if (is.null(x) || is.null(n))
      stop("Provide `data` + `var`  OR  both `x` and `n`")
    x <- as.numeric(x)
    n <- as.numeric(n)
    if (length(n) == 1L) n <- rep(n, length(x))
    if (length(x) != length(n))
      stop("`x` and `n` must be the same length")
    entries <- lapply(seq_along(x), function(i)
      list(label = as.character(i), x = x[i], n = n[i], sl = "1"))
  }

  # --- Per-entry computation ---
  results <- lapply(entries, function(e) {

    xv <- e$x; nv <- e$n

    a_post <- alpha + xv
    b_post <- beta  + (nv - xv)

    pr_mean   <- alpha / (alpha + beta)
    pr_var    <- (alpha * beta) / ((alpha + beta)^2 * (alpha + beta + 1))
    pr_mode   <- if (alpha > 1 && beta > 1) (alpha - 1) / (alpha + beta - 2) else NA_real_
    pr_median <- qbeta(0.5, shape1 = alpha, shape2 = beta)

    po_mean   <- a_post / (a_post + b_post)
    po_var    <- (a_post * b_post) / ((a_post + b_post)^2 * (a_post + b_post + 1))
    po_mode   <- if (a_post > 1 && b_post > 1) (a_post - 1) / (a_post + b_post - 2) else NA_real_
    po_median <- qbeta(0.5, shape1 = a_post, shape2 = b_post)

    all_q_int <- sort(unique(c(all_q, 0.5)))
    q_vals    <- qbeta(all_q_int, shape1 = a_post, shape2 = b_post)

    .fmt_mode <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6))

    .print_table(
      sprintf("Binomial-Beta  |  %s  |  Data Summary", e$label),
      data.frame(
        Successes          = xv,
        Trials             = nv,
        `Observed Prop`    = formatC(xv / nv, format = "f", digits = 6),
        `Success Level`    = as.character(e$sl),
        check.names        = FALSE
      )
    )

    .print_table(
      sprintf("Binomial-Beta  |  %s  |  Parameters & Moments", e$label),
      data.frame(
        Quantity  = c("alpha", "beta", "Mean", "Median", "Mode", "Variance", "SD"),
        Prior     = c(formatC(alpha,    format = "f", digits = 6),
                      formatC(beta,     format = "f", digits = 6),
                      formatC(pr_mean,  format = "f", digits = 6),
                      formatC(pr_median,format = "f", digits = 6),
                      .fmt_mode(pr_mode),
                      formatC(pr_var,   format = "f", digits = 6),
                      formatC(sqrt(pr_var), format = "f", digits = 6)),
        Posterior = c(formatC(a_post,   format = "f", digits = 6),
                      formatC(b_post,   format = "f", digits = 6),
                      formatC(po_mean,  format = "f", digits = 6),
                      formatC(po_median,format = "f", digits = 6),
                      .fmt_mode(po_mode),
                      formatC(po_var,   format = "f", digits = 6),
                      formatC(sqrt(po_var), format = "f", digits = 6)),
        stringsAsFactors = FALSE
      )
    )

    cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type)
    if (!is.null(cri_df))
      .print_table(sprintf("Binomial-Beta  |  %s  |  Credible Intervals (%s)",
                           e$label, cri_type), cri_df)

    q_df <- .build_quantile_table(quantiles, all_q_int, q_vals)
    if (!is.null(q_df))
      .print_table(sprintf("Binomial-Beta  |  %s  |  Posterior Quantiles",
                           e$label), q_df)

    # boundary protection: avoid Inf at 0 and 1 when shape params < 1
    th_lo <- if (min(alpha, beta, a_post, b_post) < 1) 1e-4 else 0
    th_hi <- if (min(alpha, beta, a_post, b_post) < 1) 1 - 1e-4 else 1
    th    <- seq(th_lo, th_hi, length.out = 1000)
    dfp <- data.frame(
      theta        = rep(th, 2),
      density      = c(dbeta(th, alpha, beta),
                       dbeta(th, a_post, b_post)),
      Distribution = factor(rep(c("Prior", "Posterior"), each = 1000),
                            levels = c("Prior", "Posterior"))
    )
    p <- ggplot(dfp, aes(x = theta, y = density)) +
      geom_line(colour = "#2C7BB6", linewidth = 0.9) +
      facet_wrap(~ Distribution, nrow = 1, scales = "free") +
      labs(
        title    = sprintf("Binomial-Beta  [%s]", e$label),
        subtitle = sprintf("Prior: Beta(%.2f, %.2f)  |  Posterior: Beta(%.2f, %.2f)",
                           alpha, beta, a_post, b_post),
        x = expression(theta), y = "Density"
      ) +
      theme_bw(base_size = 13) +
      theme(strip.text = element_text(face = "bold"))
    print(p)

    invisible(list(
      label     = e$label,
      data      = list(x = xv, n = nv, success_level = e$sl),
      prior     = list(alpha = alpha, beta = beta,
                       mean = pr_mean, median = pr_median, mode = pr_mode,
                       var = pr_var, sd = sqrt(pr_var)),
      posterior = list(alpha = a_post, beta = b_post,
                       mean = po_mean, median = po_median, mode = po_mode,
                       var = po_var, sd = sqrt(po_var),
                       quantiles = setNames(q_vals, all_q_int)),
      plot      = p
    ))
  })

  invisible(if (length(results) == 1L) results[[1L]] else results)
}

# ==========================================================================
# USAGE EXAMPLES
# ==========================================================================

# scalar
# conjugate_binomial_beta(x = 14, n = 20, alpha = 2, beta = 2,
#                          cri_levels = c(80, 90, 95, 99), quantiles = c(0.75))

# df + var (binary 0/1)
# df <- data.frame(response = c(1,0,1,1,0,1,0,0,1,1))
# conjugate_binomial_beta(data = df, var = "response",
#                         alpha = 2, beta = 2, cri_levels = c(90, 95))

# df + var (character binary) + group + success_level
# df <- data.frame(response = c("Yes","No","Yes","Yes","No","Yes","No","No","Yes","Yes"),
#                 group    = rep(c("A","B"), each = 5))
# conjugate_binomial_beta(data = df, var = "response", group_var = "group",
#                          success_level = "Yes",
#                          alpha = 2, beta = 2, cri_levels = c(90, 95))

conjugate_binomial_beta(x = 14, n = 20, alpha = 2, beta = 2,
                         cri_levels = c(80, 90, 95, 99), quantiles = c(0.75))
Bayesian Conjugate Model – Poisson-Gamma
Show code
# ========================================================================== # Bayesian Conjugate Model – Poisson-Gamma # Closed-form analytical solution (standalone script) # # Likelihood : X_i ~ Poisson(lambda) # Prior : lambda ~ Gamma(alpha, rate = beta) # Posterior : lambda | x ~ Gamma(alpha + sum(x), rate = beta + n) # # Input : scalar / vector OR data (df) + var + group_var # Output : clean console tables , ggplot, invisible list # ========================================================================== library(ggplot2) # ========================================================================== # INTERNAL UTILITIES # ========================================================================== # — console table — .print_table <- function(title, df) { col_names <- names(df) col_widths <- mapply(function(nm, col) { max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE)) }, col_names, df) col_widths <- pmax(col_widths, 10L) total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L divider <- paste(rep("=", total_width), collapse = "") thin_div <- paste(rep("-", total_width), collapse = "") header <- paste( mapply(formatC, col_names, width = col_widths, flag = "-"), collapse = " " ) lines <- character(0) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", title)) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", header)) lines <- c(lines, sprintf(" %s", thin_div)) for (i in seq_len(nrow(df))) { row_str <- paste( mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"), as.list(df[i, ]), col_widths), collapse = " " ) lines <- c(lines, sprintf(" %s", row_str)) } lines <- c(lines, divider) lines <- c(lines, "") writeLines(lines) } # --- Expand cri_levels to quantile vector --- .expand_cri <- function(cri_levels, quantiles) { q_all <- sort(unique(as.numeric(quantiles))) if (!is.null(cri_levels)) { cri_levels <- sort(unique(cri_levels)) tails <- as.vector(rbind((1 - cri_levels / 100) / 2, 1 - (1 - cri_levels / 100) / 2)) q_all <- sort(unique(c(q_all, tails))) } q_all } # --- Build CrI table (from cri_levels only - symmetric CrI pairs) --- .build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) { if (is.null(cri_levels)) return(NULL) rows <- list() for (lev in sort(unique(cri_levels))) { lo <- (1 - lev / 100) / 2 hi <- 1 - lo idx_lo <- which(abs(all_q - lo) < 1e-10) idx_hi <- which(abs(all_q - hi) < 1e-10) if (length(idx_lo) && length(idx_hi)) { rows[[length(rows) + 1L]] <- data.frame( Level = sprintf("%d%% %s", lev, cri_type), Lower = formatC(q_vals[idx_lo], format = "f", digits = 6), Upper = formatC(q_vals[idx_hi], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Build individual quantile table (from quantiles arg only) --- .build_quantile_table <- function(quantiles, all_q, q_vals) { if (is.null(quantiles) || length(quantiles) == 0L) return(NULL) rows <- list() for (q in sort(unique(quantiles))) { idx <- which(abs(all_q - q) < 1e-10) if (length(idx)) { rows[[length(rows) + 1L]] <- data.frame( Quantile = sprintf("Q(%.4f)", q), Value = formatC(q_vals[idx], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Validate data + var inputs (Poisson-Gamma) --- .validate_df_var <- function(data, var) { if (!is.data.frame(data)) stop("`data` must be a data.frame") if (is.null(var) || length(var) != 1L || !is.character(var)) stop("`var` must be a single column name (character scalar)") if (!var %in% names(data)) stop(sprintf("Column '%s' not found in data", var)) col <- data[[var]] if (all(is.na(col))) stop(sprintf("Column '%s' is entirely NA", var)) if (!is.numeric(col)) stop(sprintf("Column '%s' must be numeric for Poisson-Gamma model", var)) if (any(col < 0, na.rm = TRUE)) stop(sprintf("Column '%s' contains negative values — Poisson model requires non-negative counts", var)) if (any(col != floor(col), na.rm = TRUE)) stop(sprintf("Column '%s' contains non-integer values — Poisson model requires integer counts", var)) invisible(TRUE) } # --- Validate group_var --- .validate_group <- function(data, group_var) { if (!is.null(group_var)) { if (!group_var %in% names(data)) stop(sprintf("group_var column '%s' not found in data", group_var)) } invisible(TRUE) } # --- Split data into entries by group --- .split_entries <- function(data, var, group_var) { if (!is.null(group_var)) { grps <- unique(data[[group_var]]) lapply(grps, function(g) { list(label = sprintf("%s = %s", group_var, as.character(g)), col = data[data[[group_var]] == g, var]) }) } else { list(list(label = "All", col = data[[var]])) } } # ========================================================================== # POISSON - GAMMA # ========================================================================== conjugate_poisson_gamma <- function( data = NULL, var = NULL, group_var = NULL, x = NULL, # scalar / vector of counts OR raw count vector alpha, beta, cri_levels = c(90, 95), quantiles = NULL, cri_type = "CrI" ) { all_q <- .expand_cri(cri_levels, quantiles) if (!is.null(data)) { .validate_df_var(data, var) .validate_group(data, group_var) entries_raw <- .split_entries(data, var, group_var) entries <- lapply(entries_raw, function(e) list(label = e$label, x = na.omit(e$col))) } else { if (is.null(x)) stop("Provide `data` + `var` OR `x`") entries <- list(list(label = "All", x = as.numeric(x))) } results <- lapply(entries, function(e) { xv <- e$x nv <- length(xv) sum_x <- sum(xv) a_post <- alpha + sum_x b_post <- beta + nv pr_mean <- alpha / beta pr_var <- alpha / beta^2 pr_mode <- if (alpha >= 1) (alpha – 1) / beta else NA_real_ pr_median <- qgamma(0.5, shape = alpha, rate = beta) po_mean <- a_post / b_post po_var <- a_post / b_post^2 po_mode <- if (a_post >= 1) (a_post – 1) / b_post else NA_real_ po_median <- qgamma(0.5, shape = a_post, rate = b_post) all_q_int <- sort(unique(c(all_q, 0.5))) q_vals <- qgamma(all_q_int, shape = a_post, rate = b_post) .fmt_mode <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6)) .print_table( sprintf("Poisson-Gamma | %s | Data Summary", e$label), data.frame( n = nv, `sum(x)` = sum_x, `mean(x)` = formatC(mean(xv), format = "f", digits = 6), check.names = FALSE ) ) .print_table( sprintf("Poisson-Gamma | %s | Parameters & Moments", e$label), data.frame( Quantity = c("alpha (shape)", "beta (rate)", "Mean", "Median", "Mode", "Variance", "SD"), Prior = c(formatC(alpha, format = "f", digits = 6), formatC(beta, format = "f", digits = 6), formatC(pr_mean, format = "f", digits = 6), formatC(pr_median, format = "f", digits = 6), .fmt_mode(pr_mode), formatC(pr_var, format = "f", digits = 6), formatC(sqrt(pr_var), format = "f", digits = 6)), Posterior = c(formatC(a_post, format = "f", digits = 6), formatC(b_post, format = "f", digits = 6), formatC(po_mean, format = "f", digits = 6), formatC(po_median, format = "f", digits = 6), .fmt_mode(po_mode), formatC(po_var, format = "f", digits = 6), formatC(sqrt(po_var), format = "f", digits = 6)), stringsAsFactors = FALSE ) ) cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type) if (!is.null(cri_df)) .print_table(sprintf("Poisson-Gamma | %s | Credible Intervals (%s)", e$label, cri_type), cri_df) q_df <- .build_quantile_table(quantiles, all_q_int, q_vals) if (!is.null(q_df)) .print_table(sprintf("Poisson-Gamma | %s | Posterior Quantiles", e$label), q_df) # independent ranges per distribution, start at 1e-6 to avoid Inf at 0 when shape < 1 pr_lo <- max(1e-6, qgamma(0.001, shape = alpha, rate = beta)) pr_hi <- qgamma(0.999, shape = alpha, rate = beta) po_lo <- max(1e-6, qgamma(0.001, shape = a_post, rate = b_post)) po_hi <- qgamma(0.999, shape = a_post, rate = b_post) lam_pr <- seq(pr_lo, pr_hi, length.out = 1000) lam_po <- seq(po_lo, po_hi, length.out = 1000) dfp <- data.frame( lambda = c(lam_pr, lam_po), density = c(dgamma(lam_pr, shape = alpha, rate = beta), dgamma(lam_po, shape = a_post, rate = b_post)), Distribution = factor(rep(c("Prior", "Posterior"), each = 1000), levels = c("Prior", "Posterior")) ) p <- ggplot(dfp, aes(x = lambda, y = density)) + geom_line(colour = "#2C7BB6", linewidth = 0.9) + facet_wrap(~ Distribution, nrow = 1, scales = "free") + labs( title = sprintf("Poisson-Gamma [%s]", e$label), subtitle = sprintf("Prior: Gamma(%.2f, rate=%.2f) | Posterior: Gamma(%.2f, rate=%.2f)", alpha, beta, a_post, b_post), x = expression(lambda), y = "Density" ) + theme_bw(base_size = 13) + theme(strip.text = element_text(face = "bold")) print(p) invisible(list( label = e$label, data = list(n = nv, sum_x = sum_x), prior = list(alpha = alpha, beta = beta, mean = pr_mean, median = pr_median, mode = pr_mode, var = pr_var, sd = sqrt(pr_var)), posterior = list(alpha = a_post, beta = b_post, mean = po_mean, median = po_median, mode = po_mode, var = po_var, sd = sqrt(po_var), quantiles = setNames(q_vals, all_q_int)), plot = p )) }) invisible(if (length(results) == 1L) results[[1L]] else results) } # ========================================================================== # USAGE EXAMPLES # ========================================================================== # vector # conjugate_poisson_gamma(x = c(3,5,2,4,6), alpha = 2, beta = 1, # cri_levels = c(80, 90, 95, 99)) # df + var + group # df <- data.frame(counts = c(3,5,2,4,6,1,3,2,5,4), # site = rep(c("S1","S2"), each = 5)) # conjugate_poisson_gamma(data = df, var = "counts", group_var = "site", # alpha = 2, beta = 1, cri_levels = c(90, 95)) conjugate_poisson_gamma(x = c(3, 5, 2, 4, 6), alpha = 2, beta = 1, cri_levels = c(80, 90, 95, 99))
# ==========================================================================
# Bayesian Conjugate Model - Poisson-Gamma
# Closed-form analytical solution (standalone script)
#
# Likelihood : X_i ~ Poisson(lambda)
# Prior      : lambda ~ Gamma(alpha, rate = beta)
# Posterior  : lambda | x ~ Gamma(alpha + sum(x), rate = beta + n)
#
# Input  : scalar / vector  OR  data (df) + var + group_var
# Output : clean console tables , ggplot, invisible list
# ==========================================================================

library(ggplot2)

# ==========================================================================
# INTERNAL UTILITIES
# ==========================================================================

# --- console table ---
.print_table <- function(title, df) {
  col_names  <- names(df)
  col_widths <- mapply(function(nm, col) {
    max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE))
  }, col_names, df)
  col_widths <- pmax(col_widths, 10L)

  total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L
  divider     <- paste(rep("=", total_width), collapse = "")
  thin_div    <- paste(rep("-", total_width), collapse = "")

  header <- paste(
    mapply(formatC, col_names, width = col_widths, flag = "-"),
    collapse = "   "
  )

  lines <- character(0)
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", title))
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", header))
  lines <- c(lines, sprintf("  %s", thin_div))
  for (i in seq_len(nrow(df))) {
    row_str <- paste(
      mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"),
             as.list(df[i, ]), col_widths),
      collapse = "   "
    )
    lines <- c(lines, sprintf("  %s", row_str))
  }
  lines <- c(lines, divider)
  lines <- c(lines, "")
  writeLines(lines)
}

# --- Expand cri_levels to quantile vector ---
.expand_cri <- function(cri_levels, quantiles) {
  q_all <- sort(unique(as.numeric(quantiles)))
  if (!is.null(cri_levels)) {
    cri_levels <- sort(unique(cri_levels))
    tails      <- as.vector(rbind((1 - cri_levels / 100) / 2,
                                  1 - (1 - cri_levels / 100) / 2))
    q_all      <- sort(unique(c(q_all, tails)))
  }
  q_all
}

# --- Build CrI table (from cri_levels only - symmetric CrI pairs) ---
.build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) {
  if (is.null(cri_levels)) return(NULL)
  rows <- list()
  for (lev in sort(unique(cri_levels))) {
    lo     <- (1 - lev / 100) / 2
    hi     <- 1 - lo
    idx_lo <- which(abs(all_q - lo) < 1e-10)
    idx_hi <- which(abs(all_q - hi) < 1e-10)
    if (length(idx_lo) && length(idx_hi)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Level = sprintf("%d%% %s", lev, cri_type),
        Lower = formatC(q_vals[idx_lo], format = "f", digits = 6),
        Upper = formatC(q_vals[idx_hi], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Build individual quantile table (from quantiles arg only) ---
.build_quantile_table <- function(quantiles, all_q, q_vals) {
  if (is.null(quantiles) || length(quantiles) == 0L) return(NULL)
  rows <- list()
  for (q in sort(unique(quantiles))) {
    idx <- which(abs(all_q - q) < 1e-10)
    if (length(idx)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Quantile = sprintf("Q(%.4f)", q),
        Value    = formatC(q_vals[idx], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Validate data + var inputs (Poisson-Gamma) ---
.validate_df_var <- function(data, var) {

  if (!is.data.frame(data))
    stop("`data` must be a data.frame")

  if (is.null(var) || length(var) != 1L || !is.character(var))
    stop("`var` must be a single column name (character scalar)")

  if (!var %in% names(data))
    stop(sprintf("Column '%s' not found in data", var))

  col <- data[[var]]

  if (all(is.na(col)))
    stop(sprintf("Column '%s' is entirely NA", var))

  if (!is.numeric(col))
    stop(sprintf("Column '%s' must be numeric for Poisson-Gamma model", var))
  if (any(col < 0, na.rm = TRUE))
    stop(sprintf("Column '%s' contains negative values — Poisson model requires non-negative counts", var))
  if (any(col != floor(col), na.rm = TRUE))
    stop(sprintf("Column '%s' contains non-integer values — Poisson model requires integer counts", var))

  invisible(TRUE)
}

# --- Validate group_var ---
.validate_group <- function(data, group_var) {
  if (!is.null(group_var)) {
    if (!group_var %in% names(data))
      stop(sprintf("group_var column '%s' not found in data", group_var))
  }
  invisible(TRUE)
}

# --- Split data into entries by group ---
.split_entries <- function(data, var, group_var) {
  if (!is.null(group_var)) {
    grps <- unique(data[[group_var]])
    lapply(grps, function(g) {
      list(label = sprintf("%s = %s", group_var, as.character(g)),
           col   = data[data[[group_var]] == g, var])
    })
  } else {
    list(list(label = "All", col = data[[var]]))
  }
}

# ==========================================================================
# POISSON - GAMMA
# ==========================================================================

conjugate_poisson_gamma <- function(
    data      = NULL,
    var       = NULL,
    group_var = NULL,
    x         = NULL,   # scalar / vector of counts  OR  raw count vector
    alpha,
    beta,
    cri_levels = c(90, 95),
    quantiles  = NULL,
    cri_type   = "CrI"
) {

  all_q <- .expand_cri(cri_levels, quantiles)

  if (!is.null(data)) {
    .validate_df_var(data, var)
    .validate_group(data, group_var)
    entries_raw <- .split_entries(data, var, group_var)
    entries <- lapply(entries_raw, function(e)
      list(label = e$label, x = na.omit(e$col)))
  } else {
    if (is.null(x)) stop("Provide `data` + `var`  OR  `x`")
    entries <- list(list(label = "All", x = as.numeric(x)))
  }

  results <- lapply(entries, function(e) {

    xv    <- e$x
    nv    <- length(xv)
    sum_x <- sum(xv)

    a_post <- alpha + sum_x
    b_post <- beta  + nv

    pr_mean   <- alpha / beta
    pr_var    <- alpha / beta^2
    pr_mode   <- if (alpha >= 1) (alpha - 1) / beta else NA_real_
    pr_median <- qgamma(0.5, shape = alpha, rate = beta)

    po_mean   <- a_post / b_post
    po_var    <- a_post / b_post^2
    po_mode   <- if (a_post >= 1) (a_post - 1) / b_post else NA_real_
    po_median <- qgamma(0.5, shape = a_post, rate = b_post)

    all_q_int <- sort(unique(c(all_q, 0.5)))
    q_vals    <- qgamma(all_q_int, shape = a_post, rate = b_post)

    .fmt_mode <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6))

    .print_table(
      sprintf("Poisson-Gamma  |  %s  |  Data Summary", e$label),
      data.frame(
        n          = nv,
        `sum(x)`   = sum_x,
        `mean(x)`  = formatC(mean(xv), format = "f", digits = 6),
        check.names = FALSE
      )
    )

    .print_table(
      sprintf("Poisson-Gamma  |  %s  |  Parameters & Moments", e$label),
      data.frame(
        Quantity  = c("alpha (shape)", "beta (rate)", "Mean", "Median", "Mode", "Variance", "SD"),
        Prior     = c(formatC(alpha,     format = "f", digits = 6),
                      formatC(beta,      format = "f", digits = 6),
                      formatC(pr_mean,   format = "f", digits = 6),
                      formatC(pr_median, format = "f", digits = 6),
                      .fmt_mode(pr_mode),
                      formatC(pr_var,    format = "f", digits = 6),
                      formatC(sqrt(pr_var), format = "f", digits = 6)),
        Posterior = c(formatC(a_post,    format = "f", digits = 6),
                      formatC(b_post,    format = "f", digits = 6),
                      formatC(po_mean,   format = "f", digits = 6),
                      formatC(po_median, format = "f", digits = 6),
                      .fmt_mode(po_mode),
                      formatC(po_var,    format = "f", digits = 6),
                      formatC(sqrt(po_var), format = "f", digits = 6)),
        stringsAsFactors = FALSE
      )
    )

    cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type)
    if (!is.null(cri_df))
      .print_table(sprintf("Poisson-Gamma  |  %s  |  Credible Intervals (%s)",
                           e$label, cri_type), cri_df)

    q_df <- .build_quantile_table(quantiles, all_q_int, q_vals)
    if (!is.null(q_df))
      .print_table(sprintf("Poisson-Gamma  |  %s  |  Posterior Quantiles",
                           e$label), q_df)

    # independent ranges per distribution, start at 1e-6 to avoid Inf at 0 when shape < 1
    pr_lo  <- max(1e-6, qgamma(0.001, shape = alpha,  rate = beta))
    pr_hi  <- qgamma(0.999, shape = alpha,  rate = beta)
    po_lo  <- max(1e-6, qgamma(0.001, shape = a_post, rate = b_post))
    po_hi  <- qgamma(0.999, shape = a_post, rate = b_post)

    lam_pr  <- seq(pr_lo, pr_hi, length.out = 1000)
    lam_po  <- seq(po_lo, po_hi, length.out = 1000)

    dfp <- data.frame(
      lambda       = c(lam_pr, lam_po),
      density      = c(dgamma(lam_pr, shape = alpha,  rate = beta),
                       dgamma(lam_po, shape = a_post, rate = b_post)),
      Distribution = factor(rep(c("Prior", "Posterior"), each = 1000),
                            levels = c("Prior", "Posterior"))
    )
    p <- ggplot(dfp, aes(x = lambda, y = density)) +
      geom_line(colour = "#2C7BB6", linewidth = 0.9) +
      facet_wrap(~ Distribution, nrow = 1, scales = "free") +
      labs(
        title    = sprintf("Poisson-Gamma  [%s]", e$label),
        subtitle = sprintf("Prior: Gamma(%.2f, rate=%.2f)  |  Posterior: Gamma(%.2f, rate=%.2f)",
                           alpha, beta, a_post, b_post),
        x = expression(lambda), y = "Density"
      ) +
      theme_bw(base_size = 13) +
      theme(strip.text = element_text(face = "bold"))
    print(p)

    invisible(list(
      label     = e$label,
      data      = list(n = nv, sum_x = sum_x),
      prior     = list(alpha = alpha, beta = beta,
                       mean = pr_mean, median = pr_median, mode = pr_mode,
                       var = pr_var, sd = sqrt(pr_var)),
      posterior = list(alpha = a_post, beta = b_post,
                       mean = po_mean, median = po_median, mode = po_mode,
                       var = po_var, sd = sqrt(po_var),
                       quantiles = setNames(q_vals, all_q_int)),
      plot      = p
    ))
  })

  invisible(if (length(results) == 1L) results[[1L]] else results)
}

# ==========================================================================
# USAGE EXAMPLES
# ==========================================================================

# vector
# conjugate_poisson_gamma(x = c(3,5,2,4,6), alpha = 2, beta = 1,
#                         cri_levels = c(80, 90, 95, 99))

# df + var + group
# df <- data.frame(counts = c(3,5,2,4,6,1,3,2,5,4),
#                  site   = rep(c("S1","S2"), each = 5))
# conjugate_poisson_gamma(data = df, var = "counts", group_var = "site",
#                         alpha = 2, beta = 1, cri_levels = c(90, 95))

conjugate_poisson_gamma(x = c(3, 5, 2, 4, 6), alpha = 2, beta = 1,
                         cri_levels = c(80, 90, 95, 99))
Bayesian Conjugate Model – Normal-Normal (Mean, variance known)
Show code
# ========================================================================== # Bayesian Conjugate Model – Normal-Normal (Mean, variance known) # Closed-form analytical solution (standalone script) # # Likelihood : X_i ~ N(mu, sigma2) sigma2 known # Prior : mu ~ N(mu0, tau2) # Posterior : mu | x ~ N(mu_post, tau2_post) # tau2_post = 1 / (1/tau2 + n/sigma2) # mu_post = tau2_post * (mu0/tau2 + n*xbar/sigma2) # # Input : scalar / vector OR data (df) + var + group_var # Output : clean console tables , ggplot, invisible list # ========================================================================== library(ggplot2) # ========================================================================== # INTERNAL UTILITIES # ========================================================================== # — console table — .print_table <- function(title, df) { col_names <- names(df) col_widths <- mapply(function(nm, col) { max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE)) }, col_names, df) col_widths <- pmax(col_widths, 10L) total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L divider <- paste(rep("=", total_width), collapse = "") thin_div <- paste(rep("-", total_width), collapse = "") header <- paste( mapply(formatC, col_names, width = col_widths, flag = "-"), collapse = " " ) lines <- character(0) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", title)) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", header)) lines <- c(lines, sprintf(" %s", thin_div)) for (i in seq_len(nrow(df))) { row_str <- paste( mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"), as.list(df[i, ]), col_widths), collapse = " " ) lines <- c(lines, sprintf(" %s", row_str)) } lines <- c(lines, divider) lines <- c(lines, "") writeLines(lines) } # --- Expand cri_levels to quantile vector --- .expand_cri <- function(cri_levels, quantiles) { q_all <- sort(unique(as.numeric(quantiles))) if (!is.null(cri_levels)) { cri_levels <- sort(unique(cri_levels)) tails <- as.vector(rbind((1 - cri_levels / 100) / 2, 1 - (1 - cri_levels / 100) / 2)) q_all <- sort(unique(c(q_all, tails))) } q_all } # --- Build CrI table (from cri_levels only - symmetric CrI pairs) --- .build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) { if (is.null(cri_levels)) return(NULL) rows <- list() for (lev in sort(unique(cri_levels))) { lo <- (1 - lev / 100) / 2 hi <- 1 - lo idx_lo <- which(abs(all_q - lo) < 1e-10) idx_hi <- which(abs(all_q - hi) < 1e-10) if (length(idx_lo) && length(idx_hi)) { rows[[length(rows) + 1L]] <- data.frame( Level = sprintf("%d%% %s", lev, cri_type), Lower = formatC(q_vals[idx_lo], format = "f", digits = 6), Upper = formatC(q_vals[idx_hi], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Build individual quantile table (from quantiles arg only) --- .build_quantile_table <- function(quantiles, all_q, q_vals) { if (is.null(quantiles) || length(quantiles) == 0L) return(NULL) rows <- list() for (q in sort(unique(quantiles))) { idx <- which(abs(all_q - q) < 1e-10) if (length(idx)) { rows[[length(rows) + 1L]] <- data.frame( Quantile = sprintf("Q(%.4f)", q), Value = formatC(q_vals[idx], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Validate data + var inputs (Normal-Normal) --- .validate_df_var <- function(data, var) { if (!is.data.frame(data)) stop("`data` must be a data.frame") if (is.null(var) || length(var) != 1L || !is.character(var)) stop("`var` must be a single column name (character scalar)") if (!var %in% names(data)) stop(sprintf("Column '%s' not found in data", var)) col <- data[[var]] if (all(is.na(col))) stop(sprintf("Column '%s' is entirely NA", var)) if (!is.numeric(col)) stop(sprintf("Column '%s' must be numeric for Normal conjugate models", var)) invisible(TRUE) } # --- Validate group_var --- .validate_group <- function(data, group_var) { if (!is.null(group_var)) { if (!group_var %in% names(data)) stop(sprintf("group_var column '%s' not found in data", group_var)) } invisible(TRUE) } # --- Split data into entries by group --- .split_entries <- function(data, var, group_var) { if (!is.null(group_var)) { grps <- unique(data[[group_var]]) lapply(grps, function(g) { list(label = sprintf("%s = %s", group_var, as.character(g)), col = data[data[[group_var]] == g, var]) }) } else { list(list(label = "All", col = data[[var]])) } } # ========================================================================== # NORMAL - NORMAL (estimating MEAN | variance known) # ========================================================================== conjugate_normal_normal <- function( data = NULL, var = NULL, group_var = NULL, x = NULL, mu0, tau2, sigma2, # known likelihood variance (fixed) cri_levels = c(90, 95), quantiles = NULL, cri_type = "CrI" ) { all_q <- .expand_cri(cri_levels, quantiles) if (!is.null(data)) { .validate_df_var(data, var) .validate_group(data, group_var) entries_raw <- .split_entries(data, var, group_var) entries <- lapply(entries_raw, function(e) list(label = e$label, x = na.omit(e$col))) } else { if (is.null(x)) stop("Provide `data` + `var` OR `x`") entries <- list(list(label = "All", x = as.numeric(x))) } results <- lapply(entries, function(e) { xv <- e$x nv <- length(xv) xbar <- mean(xv) tau2_post <- 1 / (1/tau2 + nv/sigma2) mu_post <- tau2_post * (mu0/tau2 + nv*xbar/sigma2) # Normal is symmetric: mean = median = mode pr_median <- mu0 pr_mode <- mu0 po_median <- mu_post po_mode <- mu_post all_q_int <- sort(unique(c(all_q, 0.5))) q_vals <- qnorm(all_q_int, mean = mu_post, sd = sqrt(tau2_post)) .print_table( sprintf("Normal-Normal | %s | Data Summary", e$label), data.frame( n = nv, xbar = formatC(xbar, format = "f", digits = 6), `sigma2 (known)`= formatC(sigma2, format = "f", digits = 6), check.names = FALSE ) ) .print_table( sprintf("Normal-Normal | %s | Parameters & Moments", e$label), data.frame( Quantity = c("mu (mean=median=mode)", "tau2 (variance)", "SD"), Prior = formatC(c(mu0, tau2, sqrt(tau2)), format = "f", digits = 6), Posterior = formatC(c(mu_post, tau2_post, sqrt(tau2_post)), format = "f", digits = 6), stringsAsFactors = FALSE ) ) cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type) if (!is.null(cri_df)) .print_table(sprintf("Normal-Normal | %s | Credible Intervals (%s)", e$label, cri_type), cri_df) q_df <- .build_quantile_table(quantiles, all_q_int, q_vals) if (!is.null(q_df)) .print_table(sprintf("Normal-Normal | %s | Posterior Quantiles", e$label), q_df) pr_lo <- qnorm(0.001, mu0, sqrt(tau2)) pr_hi <- qnorm(0.999, mu0, sqrt(tau2)) po_lo <- qnorm(0.001, mu_post, sqrt(tau2_post)) po_hi <- qnorm(0.999, mu_post, sqrt(tau2_post)) mu_pr <- seq(pr_lo, pr_hi, length.out = 1000) mu_po <- seq(po_lo, po_hi, length.out = 1000) dfp <- data.frame( mu = c(mu_pr, mu_po), density = c(dnorm(mu_pr, mean = mu0, sd = sqrt(tau2)), dnorm(mu_po, mean = mu_post, sd = sqrt(tau2_post))), Distribution = factor(rep(c("Prior", "Posterior"), each = 1000), levels = c("Prior", "Posterior")) ) p <- ggplot(dfp, aes(x = mu, y = density)) + geom_line(colour = "#2C7BB6", linewidth = 0.9) + facet_wrap(~ Distribution, nrow = 1, scales = "free") + labs( title = sprintf("Normal-Normal (Mean) [%s]", e$label), subtitle = sprintf("Prior: N(%.4f, %.4f) | Posterior: N(%.4f, %.4f)", mu0, tau2, mu_post, tau2_post), x = expression(mu), y = "Density" ) + theme_bw(base_size = 13) + theme(strip.text = element_text(face = "bold")) print(p) invisible(list( label = e$label, data = list(n = nv, xbar = xbar, sigma2 = sigma2), prior = list(mu0 = mu0, tau2 = tau2, mean = mu0, median = pr_median, mode = pr_mode, sd = sqrt(tau2)), posterior = list(mu = mu_post, tau2 = tau2_post, mean = mu_post, median = po_median, mode = po_mode, sd = sqrt(tau2_post), quantiles = setNames(q_vals, all_q_int)), plot = p )) }) invisible(if (length(results) == 1L) results[[1L]] else results) } # ========================================================================== # USAGE EXAMPLES # ========================================================================== # vector # conjugate_normal_normal(x = c(2.1,1.9,2.3,2.0), mu0 = 2, tau2 = 1, # sigma2 = 0.5, cri_levels = c(90, 95)) # df + var + group # df <- data.frame(measure = c(2.1,1.9,2.3,2.0,2.5,2.2,1.8,2.4), # batch = rep(c("B1","B2"), each = 4)) # conjugate_normal_normal(data = df, var = "measure", group_var = "batch", # mu0 = 2, tau2 = 1, sigma2 = 0.5, # cri_levels = c(90, 95), quantiles = c(0.10, 0.75)) conjugate_normal_normal(x = c(2.1, 1.9, 2.3, 2.0), mu0 = 2, tau2 = 1, sigma2 = 0.5, cri_levels = c(90, 95))
# ==========================================================================
# Bayesian Conjugate Model - Normal-Normal (Mean, variance known)
# Closed-form analytical solution (standalone script)
#
# Likelihood : X_i ~ N(mu, sigma2)   sigma2 known
# Prior      : mu ~ N(mu0, tau2)
# Posterior  : mu | x ~ N(mu_post, tau2_post)
#   tau2_post = 1 / (1/tau2 + n/sigma2)
#   mu_post   = tau2_post * (mu0/tau2 + n*xbar/sigma2)
#
# Input  : scalar / vector  OR  data (df) + var + group_var
# Output : clean console tables , ggplot, invisible list
# ==========================================================================

library(ggplot2)

# ==========================================================================
# INTERNAL UTILITIES
# ==========================================================================

# --- console table ---
.print_table <- function(title, df) {
  col_names  <- names(df)
  col_widths <- mapply(function(nm, col) {
    max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE))
  }, col_names, df)
  col_widths <- pmax(col_widths, 10L)

  total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L
  divider     <- paste(rep("=", total_width), collapse = "")
  thin_div    <- paste(rep("-", total_width), collapse = "")

  header <- paste(
    mapply(formatC, col_names, width = col_widths, flag = "-"),
    collapse = "   "
  )

  lines <- character(0)
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", title))
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", header))
  lines <- c(lines, sprintf("  %s", thin_div))
  for (i in seq_len(nrow(df))) {
    row_str <- paste(
      mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"),
             as.list(df[i, ]), col_widths),
      collapse = "   "
    )
    lines <- c(lines, sprintf("  %s", row_str))
  }
  lines <- c(lines, divider)
  lines <- c(lines, "")
  writeLines(lines)
}

# --- Expand cri_levels to quantile vector ---
.expand_cri <- function(cri_levels, quantiles) {
  q_all <- sort(unique(as.numeric(quantiles)))
  if (!is.null(cri_levels)) {
    cri_levels <- sort(unique(cri_levels))
    tails      <- as.vector(rbind((1 - cri_levels / 100) / 2,
                                  1 - (1 - cri_levels / 100) / 2))
    q_all      <- sort(unique(c(q_all, tails)))
  }
  q_all
}

# --- Build CrI table (from cri_levels only - symmetric CrI pairs) ---
.build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) {
  if (is.null(cri_levels)) return(NULL)
  rows <- list()
  for (lev in sort(unique(cri_levels))) {
    lo     <- (1 - lev / 100) / 2
    hi     <- 1 - lo
    idx_lo <- which(abs(all_q - lo) < 1e-10)
    idx_hi <- which(abs(all_q - hi) < 1e-10)
    if (length(idx_lo) && length(idx_hi)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Level = sprintf("%d%% %s", lev, cri_type),
        Lower = formatC(q_vals[idx_lo], format = "f", digits = 6),
        Upper = formatC(q_vals[idx_hi], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Build individual quantile table (from quantiles arg only) ---
.build_quantile_table <- function(quantiles, all_q, q_vals) {
  if (is.null(quantiles) || length(quantiles) == 0L) return(NULL)
  rows <- list()
  for (q in sort(unique(quantiles))) {
    idx <- which(abs(all_q - q) < 1e-10)
    if (length(idx)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Quantile = sprintf("Q(%.4f)", q),
        Value    = formatC(q_vals[idx], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Validate data + var inputs (Normal-Normal) ---
.validate_df_var <- function(data, var) {

  if (!is.data.frame(data))
    stop("`data` must be a data.frame")

  if (is.null(var) || length(var) != 1L || !is.character(var))
    stop("`var` must be a single column name (character scalar)")

  if (!var %in% names(data))
    stop(sprintf("Column '%s' not found in data", var))

  col <- data[[var]]

  if (all(is.na(col)))
    stop(sprintf("Column '%s' is entirely NA", var))

  if (!is.numeric(col))
    stop(sprintf("Column '%s' must be numeric for Normal conjugate models", var))

  invisible(TRUE)
}

# --- Validate group_var ---
.validate_group <- function(data, group_var) {
  if (!is.null(group_var)) {
    if (!group_var %in% names(data))
      stop(sprintf("group_var column '%s' not found in data", group_var))
  }
  invisible(TRUE)
}

# --- Split data into entries by group ---
.split_entries <- function(data, var, group_var) {
  if (!is.null(group_var)) {
    grps <- unique(data[[group_var]])
    lapply(grps, function(g) {
      list(label = sprintf("%s = %s", group_var, as.character(g)),
           col   = data[data[[group_var]] == g, var])
    })
  } else {
    list(list(label = "All", col = data[[var]]))
  }
}

# ==========================================================================
# NORMAL - NORMAL  (estimating MEAN | variance known)
# ==========================================================================

conjugate_normal_normal <- function(
    data      = NULL,
    var       = NULL,
    group_var = NULL,
    x         = NULL,
    mu0,
    tau2,
    sigma2,             # known likelihood variance (fixed)
    cri_levels = c(90, 95),
    quantiles  = NULL,
    cri_type   = "CrI"
) {

  all_q <- .expand_cri(cri_levels, quantiles)

  if (!is.null(data)) {
    .validate_df_var(data, var)
    .validate_group(data, group_var)
    entries_raw <- .split_entries(data, var, group_var)
    entries <- lapply(entries_raw, function(e)
      list(label = e$label, x = na.omit(e$col)))
  } else {
    if (is.null(x)) stop("Provide `data` + `var`  OR  `x`")
    entries <- list(list(label = "All", x = as.numeric(x)))
  }

  results <- lapply(entries, function(e) {

    xv        <- e$x
    nv        <- length(xv)
    xbar      <- mean(xv)

    tau2_post <- 1 / (1/tau2 + nv/sigma2)
    mu_post   <- tau2_post * (mu0/tau2 + nv*xbar/sigma2)

    # Normal is symmetric: mean = median = mode
    pr_median <- mu0
    pr_mode   <- mu0
    po_median <- mu_post
    po_mode   <- mu_post

    all_q_int <- sort(unique(c(all_q, 0.5)))
    q_vals    <- qnorm(all_q_int, mean = mu_post, sd = sqrt(tau2_post))

    .print_table(
      sprintf("Normal-Normal  |  %s  |  Data Summary", e$label),
      data.frame(
        n               = nv,
        xbar            = formatC(xbar,   format = "f", digits = 6),
        `sigma2 (known)`= formatC(sigma2, format = "f", digits = 6),
        check.names     = FALSE
      )
    )

    .print_table(
      sprintf("Normal-Normal  |  %s  |  Parameters & Moments", e$label),
      data.frame(
        Quantity  = c("mu (mean=median=mode)", "tau2 (variance)", "SD"),
        Prior     = formatC(c(mu0,     tau2,      sqrt(tau2)),
                            format = "f", digits = 6),
        Posterior = formatC(c(mu_post, tau2_post, sqrt(tau2_post)),
                            format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    )

    cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type)
    if (!is.null(cri_df))
      .print_table(sprintf("Normal-Normal  |  %s  |  Credible Intervals (%s)",
                           e$label, cri_type), cri_df)

    q_df <- .build_quantile_table(quantiles, all_q_int, q_vals)
    if (!is.null(q_df))
      .print_table(sprintf("Normal-Normal  |  %s  |  Posterior Quantiles",
                           e$label), q_df)

    pr_lo  <- qnorm(0.001, mu0,     sqrt(tau2))
    pr_hi  <- qnorm(0.999, mu0,     sqrt(tau2))
    po_lo  <- qnorm(0.001, mu_post, sqrt(tau2_post))
    po_hi  <- qnorm(0.999, mu_post, sqrt(tau2_post))

    mu_pr  <- seq(pr_lo, pr_hi, length.out = 1000)
    mu_po  <- seq(po_lo, po_hi, length.out = 1000)

    dfp <- data.frame(
      mu           = c(mu_pr, mu_po),
      density      = c(dnorm(mu_pr, mean = mu0,     sd = sqrt(tau2)),
                       dnorm(mu_po, mean = mu_post, sd = sqrt(tau2_post))),
      Distribution = factor(rep(c("Prior", "Posterior"), each = 1000),
                            levels = c("Prior", "Posterior"))
    )
    p <- ggplot(dfp, aes(x = mu, y = density)) +
      geom_line(colour = "#2C7BB6", linewidth = 0.9) +
      facet_wrap(~ Distribution, nrow = 1, scales = "free") +
      labs(
        title    = sprintf("Normal-Normal (Mean)  [%s]", e$label),
        subtitle = sprintf("Prior: N(%.4f, %.4f)  |  Posterior: N(%.4f, %.4f)",
                           mu0, tau2, mu_post, tau2_post),
        x = expression(mu), y = "Density"
      ) +
      theme_bw(base_size = 13) +
      theme(strip.text = element_text(face = "bold"))
    print(p)

    invisible(list(
      label     = e$label,
      data      = list(n = nv, xbar = xbar, sigma2 = sigma2),
      prior     = list(mu0 = mu0, tau2 = tau2,
                       mean = mu0, median = pr_median, mode = pr_mode,
                       sd = sqrt(tau2)),
      posterior = list(mu = mu_post, tau2 = tau2_post,
                       mean = mu_post, median = po_median, mode = po_mode,
                       sd = sqrt(tau2_post),
                       quantiles = setNames(q_vals, all_q_int)),
      plot      = p
    ))
  })

  invisible(if (length(results) == 1L) results[[1L]] else results)
}

# ==========================================================================
# USAGE EXAMPLES
# ==========================================================================

# vector
# conjugate_normal_normal(x = c(2.1,1.9,2.3,2.0), mu0 = 2, tau2 = 1,
#                         sigma2 = 0.5, cri_levels = c(90, 95))

# df + var + group
# df <- data.frame(measure = c(2.1,1.9,2.3,2.0,2.5,2.2,1.8,2.4),
#                  batch   = rep(c("B1","B2"), each = 4))
# conjugate_normal_normal(data = df, var = "measure", group_var = "batch",
#                         mu0 = 2, tau2 = 1, sigma2 = 0.5,
#                         cri_levels = c(90, 95), quantiles = c(0.10, 0.75))

conjugate_normal_normal(x = c(2.1, 1.9, 2.3, 2.0), mu0 = 2, tau2 = 1,
                         sigma2 = 0.5, cri_levels = c(90, 95))
Bayesian Conjugate Model – Normal-Gamma (Precision, mean known)
Show code
# ========================================================================== # Bayesian Conjugate Model – Normal-Gamma (Precision, mean known) # Closed-form analytical solution (standalone script) # # Likelihood : X_i ~ N(mu_known, 1/phi) phi = precision # Prior : phi ~ Gamma(alpha, rate = beta) # Posterior : phi | x ~ Gamma(alpha + n/2, rate = beta + SS/2) # SS = sum((x – mu_known)^2) # # Input : scalar / vector OR data (df) + var + group_var # Output : clean console tables , ggplot, invisible list # ========================================================================== library(ggplot2) # ========================================================================== # INTERNAL UTILITIES # ========================================================================== # — console table — .print_table <- function(title, df) { col_names <- names(df) col_widths <- mapply(function(nm, col) { max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE)) }, col_names, df) col_widths <- pmax(col_widths, 10L) total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L divider <- paste(rep("=", total_width), collapse = "") thin_div <- paste(rep("-", total_width), collapse = "") header <- paste( mapply(formatC, col_names, width = col_widths, flag = "-"), collapse = " " ) lines <- character(0) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", title)) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", header)) lines <- c(lines, sprintf(" %s", thin_div)) for (i in seq_len(nrow(df))) { row_str <- paste( mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"), as.list(df[i, ]), col_widths), collapse = " " ) lines <- c(lines, sprintf(" %s", row_str)) } lines <- c(lines, divider) lines <- c(lines, "") writeLines(lines) } # --- Expand cri_levels to quantile vector --- .expand_cri <- function(cri_levels, quantiles) { q_all <- sort(unique(as.numeric(quantiles))) if (!is.null(cri_levels)) { cri_levels <- sort(unique(cri_levels)) tails <- as.vector(rbind((1 - cri_levels / 100) / 2, 1 - (1 - cri_levels / 100) / 2)) q_all <- sort(unique(c(q_all, tails))) } q_all } # --- Build CrI table (from cri_levels only - symmetric CrI pairs) --- .build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) { if (is.null(cri_levels)) return(NULL) rows <- list() for (lev in sort(unique(cri_levels))) { lo <- (1 - lev / 100) / 2 hi <- 1 - lo idx_lo <- which(abs(all_q - lo) < 1e-10) idx_hi <- which(abs(all_q - hi) < 1e-10) if (length(idx_lo) && length(idx_hi)) { rows[[length(rows) + 1L]] <- data.frame( Level = sprintf("%d%% %s", lev, cri_type), Lower = formatC(q_vals[idx_lo], format = "f", digits = 6), Upper = formatC(q_vals[idx_hi], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Build individual quantile table (from quantiles arg only) --- .build_quantile_table <- function(quantiles, all_q, q_vals) { if (is.null(quantiles) || length(quantiles) == 0L) return(NULL) rows <- list() for (q in sort(unique(quantiles))) { idx <- which(abs(all_q - q) < 1e-10) if (length(idx)) { rows[[length(rows) + 1L]] <- data.frame( Quantile = sprintf("Q(%.4f)", q), Value = formatC(q_vals[idx], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Validate data + var inputs (Normal-Gamma) --- .validate_df_var <- function(data, var) { if (!is.data.frame(data)) stop("`data` must be a data.frame") if (is.null(var) || length(var) != 1L || !is.character(var)) stop("`var` must be a single column name (character scalar)") if (!var %in% names(data)) stop(sprintf("Column '%s' not found in data", var)) col <- data[[var]] if (all(is.na(col))) stop(sprintf("Column '%s' is entirely NA", var)) if (!is.numeric(col)) stop(sprintf("Column '%s' must be numeric for Normal conjugate models", var)) invisible(TRUE) } # --- Validate group_var --- .validate_group <- function(data, group_var) { if (!is.null(group_var)) { if (!group_var %in% names(data)) stop(sprintf("group_var column '%s' not found in data", group_var)) } invisible(TRUE) } # --- Split data into entries by group --- .split_entries <- function(data, var, group_var) { if (!is.null(group_var)) { grps <- unique(data[[group_var]]) lapply(grps, function(g) { list(label = sprintf("%s = %s", group_var, as.character(g)), col = data[data[[group_var]] == g, var]) }) } else { list(list(label = "All", col = data[[var]])) } } # ========================================================================== # NORMAL - GAMMA (estimating PRECISION | mean known) # ========================================================================== conjugate_normal_gamma <- function( data = NULL, var = NULL, group_var = NULL, x = NULL, mu_known, alpha, beta, cri_levels = c(90, 95), quantiles = NULL, cri_type = "CrI" ) { all_q <- .expand_cri(cri_levels, quantiles) if (!is.null(data)) { .validate_df_var(data, var) .validate_group(data, group_var) entries_raw <- .split_entries(data, var, group_var) entries <- lapply(entries_raw, function(e) list(label = e$label, x = na.omit(e$col))) } else { if (is.null(x)) stop("Provide `data` + `var` OR `x`") entries <- list(list(label = "All", x = as.numeric(x))) } results <- lapply(entries, function(e) { xv <- e$x nv <- length(xv) ss <- sum((xv - mu_known)^2) a_post <- alpha + nv / 2 b_post <- beta + ss / 2 pr_mean <- alpha / beta pr_var <- alpha / beta^2 pr_mode <- if (alpha >= 1) (alpha – 1) / beta else NA_real_ pr_median <- qgamma(0.5, shape = alpha, rate = beta) po_mean <- a_post / b_post po_var <- a_post / b_post^2 po_mode <- if (a_post >= 1) (a_post – 1) / b_post else NA_real_ po_median <- qgamma(0.5, shape = a_post, rate = b_post) all_q_int <- sort(unique(c(all_q, 0.5))) q_vals <- qgamma(all_q_int, shape = a_post, rate = b_post) .fmt_mode <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6)) .print_table( sprintf("Normal-Gamma | %s | Data Summary", e$label), data.frame( n = nv, `mu_known` = formatC(mu_known, format = "f", digits = 6), `SS = sum((x-mu)^2)` = formatC(ss, format = "f", digits = 6), check.names = FALSE ) ) .print_table( sprintf("Normal-Gamma | %s | Parameters & Moments (Precision)", e$label), data.frame( Quantity = c("alpha (shape)", "beta (rate)", "Mean", "Median", "Mode", "Variance", "SD"), Prior = c(formatC(alpha, format = "f", digits = 6), formatC(beta, format = "f", digits = 6), formatC(pr_mean, format = "f", digits = 6), formatC(pr_median, format = "f", digits = 6), .fmt_mode(pr_mode), formatC(pr_var, format = "f", digits = 6), formatC(sqrt(pr_var), format = "f", digits = 6)), Posterior = c(formatC(a_post, format = "f", digits = 6), formatC(b_post, format = "f", digits = 6), formatC(po_mean, format = "f", digits = 6), formatC(po_median, format = "f", digits = 6), .fmt_mode(po_mode), formatC(po_var, format = "f", digits = 6), formatC(sqrt(po_var), format = "f", digits = 6)), stringsAsFactors = FALSE ) ) cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type) if (!is.null(cri_df)) .print_table(sprintf("Normal-Gamma | %s | Credible Intervals (%s) [precision scale]", e$label, cri_type), cri_df) q_df <- .build_quantile_table(quantiles, all_q_int, q_vals) if (!is.null(q_df)) .print_table(sprintf("Normal-Gamma | %s | Posterior Quantiles [precision scale]", e$label), q_df) pr_lo <- max(1e-6, qgamma(0.001, shape = alpha, rate = beta)) pr_hi <- qgamma(0.999, shape = alpha, rate = beta) po_lo <- max(1e-6, qgamma(0.001, shape = a_post, rate = b_post)) po_hi <- qgamma(0.999, shape = a_post, rate = b_post) phi_pr <- seq(pr_lo, pr_hi, length.out = 1000) phi_po <- seq(po_lo, po_hi, length.out = 1000) dfp <- data.frame( phi = c(phi_pr, phi_po), density = c(dgamma(phi_pr, shape = alpha, rate = beta), dgamma(phi_po, shape = a_post, rate = b_post)), Distribution = factor(rep(c("Prior", "Posterior"), each = 1000), levels = c("Prior", "Posterior")) ) p <- ggplot(dfp, aes(x = phi, y = density)) + geom_line(colour = "#2C7BB6", linewidth = 0.9) + facet_wrap(~ Distribution, nrow = 1, scales = "free") + labs( title = sprintf("Normal-Gamma (Precision) [%s]", e$label), subtitle = sprintf("Prior: Gamma(%.2f, rate=%.2f) | Posterior: Gamma(%.2f, rate=%.2f)", alpha, beta, a_post, b_post), x = expression(phi ~ "(precision)"), y = "Density" ) + theme_bw(base_size = 13) + theme(strip.text = element_text(face = "bold")) print(p) invisible(list( label = e$label, data = list(n = nv, mu_known = mu_known, ss = ss), prior = list(alpha = alpha, beta = beta, mean = pr_mean, median = pr_median, mode = pr_mode, var = pr_var, sd = sqrt(pr_var)), posterior = list(alpha = a_post, beta = b_post, mean = po_mean, median = po_median, mode = po_mode, var = po_var, sd = sqrt(po_var), quantiles = setNames(q_vals, all_q_int)), plot = p )) }) invisible(if (length(results) == 1L) results[[1L]] else results) } # ========================================================================== # USAGE EXAMPLES # ========================================================================== # vector # conjugate_normal_gamma(x = c(2.1,1.9,2.3,2.0), mu_known = 2, # alpha = 2, beta = 1, cri_levels = c(90, 95)) # df + var # df <- data.frame(measure = c(2.1,1.9,2.3,2.0,2.5,2.2,1.8,2.4)) # conjugate_normal_gamma(data = df, var = "measure", mu_known = 2, # alpha = 2, beta = 1, cri_levels = c(90, 95)) conjugate_normal_gamma(x = c(2.1, 1.9, 2.3, 2.0), mu_known = 2, alpha = 2, beta = 1, cri_levels = c(90, 95))
# ==========================================================================
# Bayesian Conjugate Model - Normal-Gamma (Precision, mean known)
# Closed-form analytical solution (standalone script)
#
# Likelihood : X_i ~ N(mu_known, 1/phi)   phi = precision
# Prior      : phi ~ Gamma(alpha, rate = beta)
# Posterior  : phi | x ~ Gamma(alpha + n/2, rate = beta + SS/2)
#              SS = sum((x - mu_known)^2)
#
# Input  : scalar / vector  OR  data (df) + var + group_var
# Output : clean console tables , ggplot, invisible list
# ==========================================================================

library(ggplot2)

# ==========================================================================
# INTERNAL UTILITIES
# ==========================================================================

# --- console table ---
.print_table <- function(title, df) {
  col_names  <- names(df)
  col_widths <- mapply(function(nm, col) {
    max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE))
  }, col_names, df)
  col_widths <- pmax(col_widths, 10L)

  total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L
  divider     <- paste(rep("=", total_width), collapse = "")
  thin_div    <- paste(rep("-", total_width), collapse = "")

  header <- paste(
    mapply(formatC, col_names, width = col_widths, flag = "-"),
    collapse = "   "
  )

  lines <- character(0)
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", title))
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", header))
  lines <- c(lines, sprintf("  %s", thin_div))
  for (i in seq_len(nrow(df))) {
    row_str <- paste(
      mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"),
             as.list(df[i, ]), col_widths),
      collapse = "   "
    )
    lines <- c(lines, sprintf("  %s", row_str))
  }
  lines <- c(lines, divider)
  lines <- c(lines, "")
  writeLines(lines)
}

# --- Expand cri_levels to quantile vector ---
.expand_cri <- function(cri_levels, quantiles) {
  q_all <- sort(unique(as.numeric(quantiles)))
  if (!is.null(cri_levels)) {
    cri_levels <- sort(unique(cri_levels))
    tails      <- as.vector(rbind((1 - cri_levels / 100) / 2,
                                  1 - (1 - cri_levels / 100) / 2))
    q_all      <- sort(unique(c(q_all, tails)))
  }
  q_all
}

# --- Build CrI table (from cri_levels only - symmetric CrI pairs) ---
.build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) {
  if (is.null(cri_levels)) return(NULL)
  rows <- list()
  for (lev in sort(unique(cri_levels))) {
    lo     <- (1 - lev / 100) / 2
    hi     <- 1 - lo
    idx_lo <- which(abs(all_q - lo) < 1e-10)
    idx_hi <- which(abs(all_q - hi) < 1e-10)
    if (length(idx_lo) && length(idx_hi)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Level = sprintf("%d%% %s", lev, cri_type),
        Lower = formatC(q_vals[idx_lo], format = "f", digits = 6),
        Upper = formatC(q_vals[idx_hi], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Build individual quantile table (from quantiles arg only) ---
.build_quantile_table <- function(quantiles, all_q, q_vals) {
  if (is.null(quantiles) || length(quantiles) == 0L) return(NULL)
  rows <- list()
  for (q in sort(unique(quantiles))) {
    idx <- which(abs(all_q - q) < 1e-10)
    if (length(idx)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Quantile = sprintf("Q(%.4f)", q),
        Value    = formatC(q_vals[idx], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Validate data + var inputs (Normal-Gamma) ---
.validate_df_var <- function(data, var) {

  if (!is.data.frame(data))
    stop("`data` must be a data.frame")

  if (is.null(var) || length(var) != 1L || !is.character(var))
    stop("`var` must be a single column name (character scalar)")

  if (!var %in% names(data))
    stop(sprintf("Column '%s' not found in data", var))

  col <- data[[var]]

  if (all(is.na(col)))
    stop(sprintf("Column '%s' is entirely NA", var))

  if (!is.numeric(col))
    stop(sprintf("Column '%s' must be numeric for Normal conjugate models", var))

  invisible(TRUE)
}

# --- Validate group_var ---
.validate_group <- function(data, group_var) {
  if (!is.null(group_var)) {
    if (!group_var %in% names(data))
      stop(sprintf("group_var column '%s' not found in data", group_var))
  }
  invisible(TRUE)
}

# --- Split data into entries by group ---
.split_entries <- function(data, var, group_var) {
  if (!is.null(group_var)) {
    grps <- unique(data[[group_var]])
    lapply(grps, function(g) {
      list(label = sprintf("%s = %s", group_var, as.character(g)),
           col   = data[data[[group_var]] == g, var])
    })
  } else {
    list(list(label = "All", col = data[[var]]))
  }
}

# ==========================================================================
# NORMAL - GAMMA  (estimating PRECISION | mean known)
# ==========================================================================

conjugate_normal_gamma <- function(
    data      = NULL,
    var       = NULL,
    group_var = NULL,
    x         = NULL,
    mu_known,
    alpha,
    beta,
    cri_levels = c(90, 95),
    quantiles  = NULL,
    cri_type   = "CrI"
) {

  all_q <- .expand_cri(cri_levels, quantiles)

  if (!is.null(data)) {
    .validate_df_var(data, var)
    .validate_group(data, group_var)
    entries_raw <- .split_entries(data, var, group_var)
    entries <- lapply(entries_raw, function(e)
      list(label = e$label, x = na.omit(e$col)))
  } else {
    if (is.null(x)) stop("Provide `data` + `var`  OR  `x`")
    entries <- list(list(label = "All", x = as.numeric(x)))
  }

  results <- lapply(entries, function(e) {

    xv     <- e$x
    nv     <- length(xv)
    ss     <- sum((xv - mu_known)^2)

    a_post <- alpha + nv / 2
    b_post <- beta  + ss  / 2

    pr_mean   <- alpha / beta
    pr_var    <- alpha / beta^2
    pr_mode   <- if (alpha >= 1) (alpha - 1) / beta else NA_real_
    pr_median <- qgamma(0.5, shape = alpha, rate = beta)

    po_mean   <- a_post / b_post
    po_var    <- a_post / b_post^2
    po_mode   <- if (a_post >= 1) (a_post - 1) / b_post else NA_real_
    po_median <- qgamma(0.5, shape = a_post, rate = b_post)

    all_q_int <- sort(unique(c(all_q, 0.5)))
    q_vals    <- qgamma(all_q_int, shape = a_post, rate = b_post)

    .fmt_mode <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6))

    .print_table(
      sprintf("Normal-Gamma  |  %s  |  Data Summary", e$label),
      data.frame(
        n                    = nv,
        `mu_known`           = formatC(mu_known, format = "f", digits = 6),
        `SS = sum((x-mu)^2)` = formatC(ss,       format = "f", digits = 6),
        check.names          = FALSE
      )
    )

    .print_table(
      sprintf("Normal-Gamma  |  %s  |  Parameters & Moments (Precision)", e$label),
      data.frame(
        Quantity  = c("alpha (shape)", "beta (rate)", "Mean", "Median", "Mode", "Variance", "SD"),
        Prior     = c(formatC(alpha,     format = "f", digits = 6),
                      formatC(beta,      format = "f", digits = 6),
                      formatC(pr_mean,   format = "f", digits = 6),
                      formatC(pr_median, format = "f", digits = 6),
                      .fmt_mode(pr_mode),
                      formatC(pr_var,    format = "f", digits = 6),
                      formatC(sqrt(pr_var), format = "f", digits = 6)),
        Posterior = c(formatC(a_post,    format = "f", digits = 6),
                      formatC(b_post,    format = "f", digits = 6),
                      formatC(po_mean,   format = "f", digits = 6),
                      formatC(po_median, format = "f", digits = 6),
                      .fmt_mode(po_mode),
                      formatC(po_var,    format = "f", digits = 6),
                      formatC(sqrt(po_var), format = "f", digits = 6)),
        stringsAsFactors = FALSE
      )
    )

    cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type)
    if (!is.null(cri_df))
      .print_table(sprintf("Normal-Gamma  |  %s  |  Credible Intervals (%s) [precision scale]",
                           e$label, cri_type), cri_df)

    q_df <- .build_quantile_table(quantiles, all_q_int, q_vals)
    if (!is.null(q_df))
      .print_table(sprintf("Normal-Gamma  |  %s  |  Posterior Quantiles [precision scale]",
                           e$label), q_df)

    pr_lo  <- max(1e-6, qgamma(0.001, shape = alpha,  rate = beta))
    pr_hi  <- qgamma(0.999, shape = alpha,  rate = beta)
    po_lo  <- max(1e-6, qgamma(0.001, shape = a_post, rate = b_post))
    po_hi  <- qgamma(0.999, shape = a_post, rate = b_post)

    phi_pr <- seq(pr_lo, pr_hi, length.out = 1000)
    phi_po <- seq(po_lo, po_hi, length.out = 1000)

    dfp <- data.frame(
      phi          = c(phi_pr, phi_po),
      density      = c(dgamma(phi_pr, shape = alpha,  rate = beta),
                       dgamma(phi_po, shape = a_post, rate = b_post)),
      Distribution = factor(rep(c("Prior", "Posterior"), each = 1000),
                            levels = c("Prior", "Posterior"))
    )
    p <- ggplot(dfp, aes(x = phi, y = density)) +
      geom_line(colour = "#2C7BB6", linewidth = 0.9) +
      facet_wrap(~ Distribution, nrow = 1, scales = "free") +
      labs(
        title    = sprintf("Normal-Gamma (Precision)  [%s]", e$label),
        subtitle = sprintf("Prior: Gamma(%.2f, rate=%.2f)  |  Posterior: Gamma(%.2f, rate=%.2f)",
                           alpha, beta, a_post, b_post),
        x = expression(phi ~ "(precision)"), y = "Density"
      ) +
      theme_bw(base_size = 13) +
      theme(strip.text = element_text(face = "bold"))
    print(p)

    invisible(list(
      label     = e$label,
      data      = list(n = nv, mu_known = mu_known, ss = ss),
      prior     = list(alpha = alpha, beta = beta,
                       mean = pr_mean, median = pr_median, mode = pr_mode,
                       var = pr_var, sd = sqrt(pr_var)),
      posterior = list(alpha = a_post, beta = b_post,
                       mean = po_mean, median = po_median, mode = po_mode,
                       var = po_var, sd = sqrt(po_var),
                       quantiles = setNames(q_vals, all_q_int)),
      plot      = p
    ))
  })

  invisible(if (length(results) == 1L) results[[1L]] else results)
}

# ==========================================================================
# USAGE EXAMPLES
# ==========================================================================

# vector
# conjugate_normal_gamma(x = c(2.1,1.9,2.3,2.0), mu_known = 2,
#                        alpha = 2, beta = 1, cri_levels = c(90, 95))

# df + var
# df <- data.frame(measure = c(2.1,1.9,2.3,2.0,2.5,2.2,1.8,2.4))
# conjugate_normal_gamma(data = df, var = "measure", mu_known = 2,
#                        alpha = 2, beta = 1, cri_levels = c(90, 95))

conjugate_normal_gamma(x = c(2.1, 1.9, 2.3, 2.0), mu_known = 2,
                        alpha = 2, beta = 1, cri_levels = c(90, 95))
Bayesian Conjugate Model – Normal-Inverse-Gamma (Variance, mean known)
Show code
# ========================================================================== # Bayesian Conjugate Model – Normal-Inverse-Gamma (Variance, mean known) # Closed-form analytical solution (standalone script) # # Likelihood : X_i ~ N(mu_known, sigma2) # Prior : sigma2 ~ InvGamma(alpha, scale = beta) # Posterior : sigma2 | x ~ InvGamma(alpha + n/2, scale = beta + SS/2) # # InvGamma(a, b) moments: # Mean = b / (a – 1) for a > 1 # Var = b^2 / ((a-1)^2 * (a-2)) for a > 2 # # Quantile: 1 / qgamma(1 – p, shape = a, rate = b) # # Input : scalar / vector OR data (df) + var + group_var # Output : clean console tables , ggplot, invisible list # ========================================================================== library(ggplot2) # ========================================================================== # INTERNAL UTILITIES # ========================================================================== # — console table — .print_table <- function(title, df) { col_names <- names(df) col_widths <- mapply(function(nm, col) { max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE)) }, col_names, df) col_widths <- pmax(col_widths, 10L) total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L divider <- paste(rep("=", total_width), collapse = "") thin_div <- paste(rep("-", total_width), collapse = "") header <- paste( mapply(formatC, col_names, width = col_widths, flag = "-"), collapse = " " ) lines <- character(0) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", title)) lines <- c(lines, divider) lines <- c(lines, sprintf(" %s", header)) lines <- c(lines, sprintf(" %s", thin_div)) for (i in seq_len(nrow(df))) { row_str <- paste( mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"), as.list(df[i, ]), col_widths), collapse = " " ) lines <- c(lines, sprintf(" %s", row_str)) } lines <- c(lines, divider) lines <- c(lines, "") writeLines(lines) } # --- Expand cri_levels to quantile vector --- .expand_cri <- function(cri_levels, quantiles) { q_all <- sort(unique(as.numeric(quantiles))) if (!is.null(cri_levels)) { cri_levels <- sort(unique(cri_levels)) tails <- as.vector(rbind((1 - cri_levels / 100) / 2, 1 - (1 - cri_levels / 100) / 2)) q_all <- sort(unique(c(q_all, tails))) } q_all } # --- Build CrI table (from cri_levels only - symmetric CrI pairs) --- .build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) { if (is.null(cri_levels)) return(NULL) rows <- list() for (lev in sort(unique(cri_levels))) { lo <- (1 - lev / 100) / 2 hi <- 1 - lo idx_lo <- which(abs(all_q - lo) < 1e-10) idx_hi <- which(abs(all_q - hi) < 1e-10) if (length(idx_lo) && length(idx_hi)) { rows[[length(rows) + 1L]] <- data.frame( Level = sprintf("%d%% %s", lev, cri_type), Lower = formatC(q_vals[idx_lo], format = "f", digits = 6), Upper = formatC(q_vals[idx_hi], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Build individual quantile table (from quantiles arg only) --- .build_quantile_table <- function(quantiles, all_q, q_vals) { if (is.null(quantiles) || length(quantiles) == 0L) return(NULL) rows <- list() for (q in sort(unique(quantiles))) { idx <- which(abs(all_q - q) < 1e-10) if (length(idx)) { rows[[length(rows) + 1L]] <- data.frame( Quantile = sprintf("Q(%.4f)", q), Value = formatC(q_vals[idx], format = "f", digits = 6), stringsAsFactors = FALSE ) } } if (length(rows)) do.call(rbind, rows) else NULL } # --- Validate data + var inputs (Normal-InvGamma) --- .validate_df_var <- function(data, var) { if (!is.data.frame(data)) stop("`data` must be a data.frame") if (is.null(var) || length(var) != 1L || !is.character(var)) stop("`var` must be a single column name (character scalar)") if (!var %in% names(data)) stop(sprintf("Column '%s' not found in data", var)) col <- data[[var]] if (all(is.na(col))) stop(sprintf("Column '%s' is entirely NA", var)) if (!is.numeric(col)) stop(sprintf("Column '%s' must be numeric for Normal conjugate models", var)) invisible(TRUE) } # --- Validate group_var --- .validate_group <- function(data, group_var) { if (!is.null(group_var)) { if (!group_var %in% names(data)) stop(sprintf("group_var column '%s' not found in data", group_var)) } invisible(TRUE) } # --- Split data into entries by group --- .split_entries <- function(data, var, group_var) { if (!is.null(group_var)) { grps <- unique(data[[group_var]]) lapply(grps, function(g) { list(label = sprintf("%s = %s", group_var, as.character(g)), col = data[data[[group_var]] == g, var]) }) } else { list(list(label = "All", col = data[[var]])) } } # ========================================================================== # NORMAL - INVERSE GAMMA (estimating VARIANCE | mean known) # ========================================================================== conjugate_normal_igamma <- function( data = NULL, var = NULL, group_var = NULL, x = NULL, mu_known, alpha, beta, cri_levels = c(90, 95), quantiles = NULL, cri_type = "CrI" ) { all_q <- .expand_cri(cri_levels, quantiles) .ig_mean <- function(a, b) if (a > 1) b / (a – 1) else NA_real_ .ig_var <- function(a, b) if (a > 2) b^2 / ((a-1)^2 * (a-2)) else NA_real_ .ig_q <- function(p, a, b) 1 / qgamma(1 - p, shape = a, rate = b) .fmt <- function(v) ifelse(is.na(v), "undefined", formatC(v, format = "f", digits = 6)) .dig <- function(x, a, b) dgamma(1/x, shape = a, rate = b) / x^2 if (!is.null(data)) { .validate_df_var(data, var) .validate_group(data, group_var) entries_raw <- .split_entries(data, var, group_var) entries <- lapply(entries_raw, function(e) list(label = e$label, x = na.omit(e$col))) } else { if (is.null(x)) stop("Provide `data` + `var` OR `x`") entries <- list(list(label = "All", x = as.numeric(x))) } results <- lapply(entries, function(e) { xv <- e$x nv <- length(xv) ss <- sum((xv - mu_known)^2) a_post <- alpha + nv / 2 b_post <- beta + ss / 2 pr_mean <- .ig_mean(alpha, beta) pr_var <- .ig_var (alpha, beta) pr_mode <- beta / (alpha + 1) # always defined pr_median <- .ig_q(0.5, alpha, beta) po_mean <- .ig_mean(a_post, b_post) po_var <- .ig_var (a_post, b_post) po_mode <- b_post / (a_post + 1) # always defined po_median <- .ig_q(0.5, a_post, b_post) all_q_int <- sort(unique(c(all_q, 0.5))) q_vals <- sapply(all_q_int, .ig_q, a = a_post, b = b_post) .print_table( sprintf("Normal-IGamma | %s | Data Summary", e$label), data.frame( n = nv, `mu_known` = formatC(mu_known, format = "f", digits = 6), `SS = sum((x-mu)^2)` = formatC(ss, format = "f", digits = 6), check.names = FALSE ) ) .print_table( sprintf("Normal-IGamma | %s | Parameters & Moments (Variance)", e$label), data.frame( Quantity = c("alpha (shape)", "beta (scale)", "Mean", "Median", "Mode", "Variance", "SD"), Prior = c(.fmt(alpha), .fmt(beta), .fmt(pr_mean), .fmt(pr_median), .fmt(pr_mode), .fmt(pr_var), .fmt(if (!is.na(pr_var)) sqrt(pr_var) else NA_real_)), Posterior = c(.fmt(a_post), .fmt(b_post), .fmt(po_mean), .fmt(po_median), .fmt(po_mode), .fmt(po_var), .fmt(if (!is.na(po_var)) sqrt(po_var) else NA_real_)), stringsAsFactors = FALSE ) ) cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type) if (!is.null(cri_df)) .print_table(sprintf("Normal-IGamma | %s | Credible Intervals (%s) [variance scale]", e$label, cri_type), cri_df) q_df <- .build_quantile_table(quantiles, all_q_int, q_vals) if (!is.null(q_df)) .print_table(sprintf("Normal-IGamma | %s | Posterior Quantiles [variance scale]", e$label), q_df) # independent range per distribution — prior and posterior on own natural scales pr_lo <- .ig_q(0.001, alpha, beta) pr_hi <- .ig_q(0.999, alpha, beta) po_lo <- .ig_q(0.001, a_post, b_post) po_hi <- .ig_q(0.999, a_post, b_post) s2_pr <- seq(max(pr_lo * 0.5, 1e-6), pr_hi, length.out = 1000) s2_po <- seq(max(po_lo * 0.5, 1e-6), po_hi, length.out = 1000) dfp <- data.frame( sigma2 = c(s2_pr, s2_po), density = c(.dig(s2_pr, alpha, beta), .dig(s2_po, a_post, b_post)), Distribution = factor(rep(c("Prior", "Posterior"), each = 1000), levels = c("Prior", "Posterior")) ) p <- ggplot(dfp, aes(x = sigma2, y = density)) + geom_line(colour = "#2C7BB6", linewidth = 0.9) + facet_wrap(~ Distribution, nrow = 1, scales = "free") + labs( title = sprintf("Normal-InvGamma (Variance) [%s]", e$label), subtitle = sprintf("Prior: IG(%.2f, %.2f) | Posterior: IG(%.2f, %.2f)", alpha, beta, a_post, b_post), x = expression(sigma^2 ~ "(variance)"), y = "Density" ) + theme_bw(base_size = 13) + theme(strip.text = element_text(face = "bold")) print(p) invisible(list( label = e$label, data = list(n = nv, mu_known = mu_known, ss = ss), prior = list(alpha = alpha, beta = beta, mean = pr_mean, median = pr_median, mode = pr_mode, var = pr_var, sd = if (!is.na(pr_var)) sqrt(pr_var) else NA_real_), posterior = list(alpha = a_post, beta = b_post, mean = po_mean, median = po_median, mode = po_mode, var = po_var, sd = if (!is.na(po_var)) sqrt(po_var) else NA_real_, quantiles = setNames(q_vals, all_q_int)), plot = p )) }) invisible(if (length(results) == 1L) results[[1L]] else results) } # ========================================================================== # USAGE EXAMPLES # ========================================================================== # vector # conjugate_normal_igamma(x = c(2.1,1.9,2.3,2.0), mu_known = 2, # alpha = 3, beta = 1, cri_levels = c(90, 95)) # df + var # df <- data.frame(measure = c(2.1,1.9,2.3,2.0,2.5,2.2,1.8,2.4)) # conjugate_normal_igamma(data = df, var = "measure", mu_known = 2, # alpha = 3, beta = 1, cri_levels = c(90, 95), # quantiles = c(0.01, 0.10)) conjugate_normal_igamma(x = c(2.1, 1.9, 2.3, 2.0), mu_known = 2, alpha = 3, beta = 1, cri_levels = c(90, 95))
# ==========================================================================
# Bayesian Conjugate Model - Normal-Inverse-Gamma (Variance, mean known)
# Closed-form analytical solution (standalone script)
#
# Likelihood : X_i ~ N(mu_known, sigma2)
# Prior      : sigma2 ~ InvGamma(alpha, scale = beta)
# Posterior  : sigma2 | x ~ InvGamma(alpha + n/2, scale = beta + SS/2)
#
# InvGamma(a, b) moments:
#   Mean = b / (a - 1)               for a > 1
#   Var  = b^2 / ((a-1)^2 * (a-2))  for a > 2
#
# Quantile: 1 / qgamma(1 - p, shape = a, rate = b)
#
# Input  : scalar / vector  OR  data (df) + var + group_var
# Output : clean console tables , ggplot, invisible list
# ==========================================================================

library(ggplot2)

# ==========================================================================
# INTERNAL UTILITIES
# ==========================================================================

# --- console table ---
.print_table <- function(title, df) {
  col_names  <- names(df)
  col_widths <- mapply(function(nm, col) {
    max(nchar(nm), max(nchar(as.character(col)), na.rm = TRUE))
  }, col_names, df)
  col_widths <- pmax(col_widths, 10L)

  total_width <- sum(col_widths) + 3L * (length(col_widths) - 1L) + 2L
  divider     <- paste(rep("=", total_width), collapse = "")
  thin_div    <- paste(rep("-", total_width), collapse = "")

  header <- paste(
    mapply(formatC, col_names, width = col_widths, flag = "-"),
    collapse = "   "
  )

  lines <- character(0)
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", title))
  lines <- c(lines, divider)
  lines <- c(lines, sprintf("  %s", header))
  lines <- c(lines, sprintf("  %s", thin_div))
  for (i in seq_len(nrow(df))) {
    row_str <- paste(
      mapply(function(val, w) formatC(as.character(val), width = w, flag = "-"),
             as.list(df[i, ]), col_widths),
      collapse = "   "
    )
    lines <- c(lines, sprintf("  %s", row_str))
  }
  lines <- c(lines, divider)
  lines <- c(lines, "")
  writeLines(lines)
}

# --- Expand cri_levels to quantile vector ---
.expand_cri <- function(cri_levels, quantiles) {
  q_all <- sort(unique(as.numeric(quantiles)))
  if (!is.null(cri_levels)) {
    cri_levels <- sort(unique(cri_levels))
    tails      <- as.vector(rbind((1 - cri_levels / 100) / 2,
                                  1 - (1 - cri_levels / 100) / 2))
    q_all      <- sort(unique(c(q_all, tails)))
  }
  q_all
}

# --- Build CrI table (from cri_levels only - symmetric CrI pairs) ---
.build_cri_table <- function(cri_levels, all_q, q_vals, cri_type) {
  if (is.null(cri_levels)) return(NULL)
  rows <- list()
  for (lev in sort(unique(cri_levels))) {
    lo     <- (1 - lev / 100) / 2
    hi     <- 1 - lo
    idx_lo <- which(abs(all_q - lo) < 1e-10)
    idx_hi <- which(abs(all_q - hi) < 1e-10)
    if (length(idx_lo) && length(idx_hi)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Level = sprintf("%d%% %s", lev, cri_type),
        Lower = formatC(q_vals[idx_lo], format = "f", digits = 6),
        Upper = formatC(q_vals[idx_hi], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Build individual quantile table (from quantiles arg only) ---
.build_quantile_table <- function(quantiles, all_q, q_vals) {
  if (is.null(quantiles) || length(quantiles) == 0L) return(NULL)
  rows <- list()
  for (q in sort(unique(quantiles))) {
    idx <- which(abs(all_q - q) < 1e-10)
    if (length(idx)) {
      rows[[length(rows) + 1L]] <- data.frame(
        Quantile = sprintf("Q(%.4f)", q),
        Value    = formatC(q_vals[idx], format = "f", digits = 6),
        stringsAsFactors = FALSE
      )
    }
  }
  if (length(rows)) do.call(rbind, rows) else NULL
}

# --- Validate data + var inputs (Normal-InvGamma) ---
.validate_df_var <- function(data, var) {

  if (!is.data.frame(data))
    stop("`data` must be a data.frame")

  if (is.null(var) || length(var) != 1L || !is.character(var))
    stop("`var` must be a single column name (character scalar)")

  if (!var %in% names(data))
    stop(sprintf("Column '%s' not found in data", var))

  col <- data[[var]]

  if (all(is.na(col)))
    stop(sprintf("Column '%s' is entirely NA", var))

  if (!is.numeric(col))
    stop(sprintf("Column '%s' must be numeric for Normal conjugate models", var))

  invisible(TRUE)
}

# --- Validate group_var ---
.validate_group <- function(data, group_var) {
  if (!is.null(group_var)) {
    if (!group_var %in% names(data))
      stop(sprintf("group_var column '%s' not found in data", group_var))
  }
  invisible(TRUE)
}

# --- Split data into entries by group ---
.split_entries <- function(data, var, group_var) {
  if (!is.null(group_var)) {
    grps <- unique(data[[group_var]])
    lapply(grps, function(g) {
      list(label = sprintf("%s = %s", group_var, as.character(g)),
           col   = data[data[[group_var]] == g, var])
    })
  } else {
    list(list(label = "All", col = data[[var]]))
  }
}

# ==========================================================================
# NORMAL - INVERSE GAMMA  (estimating VARIANCE | mean known)
# ==========================================================================

conjugate_normal_igamma <- function(
    data      = NULL,
    var       = NULL,
    group_var = NULL,
    x         = NULL,
    mu_known,
    alpha,
    beta,
    cri_levels = c(90, 95),
    quantiles  = NULL,
    cri_type   = "CrI"
) {

  all_q <- .expand_cri(cri_levels, quantiles)

  .ig_mean <- function(a, b) if (a > 1) b / (a - 1)              else NA_real_
  .ig_var  <- function(a, b) if (a > 2) b^2 / ((a-1)^2 * (a-2)) else NA_real_
  .ig_q    <- function(p, a, b) 1 / qgamma(1 - p, shape = a, rate = b)
  .fmt     <- function(v) ifelse(is.na(v), "undefined",
                                 formatC(v, format = "f", digits = 6))
  .dig     <- function(x, a, b) dgamma(1/x, shape = a, rate = b) / x^2

  if (!is.null(data)) {
    .validate_df_var(data, var)
    .validate_group(data, group_var)
    entries_raw <- .split_entries(data, var, group_var)
    entries <- lapply(entries_raw, function(e)
      list(label = e$label, x = na.omit(e$col)))
  } else {
    if (is.null(x)) stop("Provide `data` + `var`  OR  `x`")
    entries <- list(list(label = "All", x = as.numeric(x)))
  }

  results <- lapply(entries, function(e) {

    xv     <- e$x
    nv     <- length(xv)
    ss     <- sum((xv - mu_known)^2)

    a_post <- alpha + nv / 2
    b_post <- beta  + ss  / 2

    pr_mean   <- .ig_mean(alpha,  beta)
    pr_var    <- .ig_var (alpha,  beta)
    pr_mode   <- beta  / (alpha  + 1)          # always defined
    pr_median <- .ig_q(0.5, alpha,  beta)

    po_mean   <- .ig_mean(a_post, b_post)
    po_var    <- .ig_var (a_post, b_post)
    po_mode   <- b_post / (a_post + 1)          # always defined
    po_median <- .ig_q(0.5, a_post, b_post)

    all_q_int <- sort(unique(c(all_q, 0.5)))
    q_vals    <- sapply(all_q_int, .ig_q, a = a_post, b = b_post)

    .print_table(
      sprintf("Normal-IGamma  |  %s  |  Data Summary", e$label),
      data.frame(
        n                    = nv,
        `mu_known`           = formatC(mu_known, format = "f", digits = 6),
        `SS = sum((x-mu)^2)` = formatC(ss,       format = "f", digits = 6),
        check.names          = FALSE
      )
    )

    .print_table(
      sprintf("Normal-IGamma  |  %s  |  Parameters & Moments (Variance)", e$label),
      data.frame(
        Quantity  = c("alpha (shape)", "beta (scale)", "Mean", "Median", "Mode", "Variance", "SD"),
        Prior     = c(.fmt(alpha),  .fmt(beta),
                      .fmt(pr_mean), .fmt(pr_median), .fmt(pr_mode),
                      .fmt(pr_var),
                      .fmt(if (!is.na(pr_var)) sqrt(pr_var) else NA_real_)),
        Posterior = c(.fmt(a_post), .fmt(b_post),
                      .fmt(po_mean), .fmt(po_median), .fmt(po_mode),
                      .fmt(po_var),
                      .fmt(if (!is.na(po_var)) sqrt(po_var) else NA_real_)),
        stringsAsFactors = FALSE
      )
    )

    cri_df <- .build_cri_table(cri_levels, all_q_int, q_vals, cri_type)
    if (!is.null(cri_df))
      .print_table(sprintf("Normal-IGamma  |  %s  |  Credible Intervals (%s) [variance scale]",
                           e$label, cri_type), cri_df)

    q_df <- .build_quantile_table(quantiles, all_q_int, q_vals)
    if (!is.null(q_df))
      .print_table(sprintf("Normal-IGamma  |  %s  |  Posterior Quantiles [variance scale]",
                           e$label), q_df)

    # independent range per distribution — prior and posterior on own natural scales
    pr_lo  <- .ig_q(0.001, alpha,  beta)
    pr_hi  <- .ig_q(0.999, alpha,  beta)
    po_lo  <- .ig_q(0.001, a_post, b_post)
    po_hi  <- .ig_q(0.999, a_post, b_post)

    s2_pr  <- seq(max(pr_lo * 0.5, 1e-6), pr_hi, length.out = 1000)
    s2_po  <- seq(max(po_lo * 0.5, 1e-6), po_hi, length.out = 1000)

    dfp <- data.frame(
      sigma2       = c(s2_pr, s2_po),
      density      = c(.dig(s2_pr, alpha,  beta),
                       .dig(s2_po, a_post, b_post)),
      Distribution = factor(rep(c("Prior", "Posterior"), each = 1000),
                            levels = c("Prior", "Posterior"))
    )
    p <- ggplot(dfp, aes(x = sigma2, y = density)) +
      geom_line(colour = "#2C7BB6", linewidth = 0.9) +
      facet_wrap(~ Distribution, nrow = 1, scales = "free") +
      labs(
        title    = sprintf("Normal-InvGamma (Variance)  [%s]", e$label),
        subtitle = sprintf("Prior: IG(%.2f, %.2f)  |  Posterior: IG(%.2f, %.2f)",
                           alpha, beta, a_post, b_post),
        x = expression(sigma^2 ~ "(variance)"), y = "Density"
      ) +
      theme_bw(base_size = 13) +
      theme(strip.text = element_text(face = "bold"))
    print(p)

    invisible(list(
      label     = e$label,
      data      = list(n = nv, mu_known = mu_known, ss = ss),
      prior     = list(alpha = alpha, beta = beta,
                       mean = pr_mean, median = pr_median, mode = pr_mode,
                       var = pr_var,
                       sd  = if (!is.na(pr_var)) sqrt(pr_var) else NA_real_),
      posterior = list(alpha = a_post, beta = b_post,
                       mean = po_mean, median = po_median, mode = po_mode,
                       var = po_var,
                       sd  = if (!is.na(po_var)) sqrt(po_var) else NA_real_,
                       quantiles = setNames(q_vals, all_q_int)),
      plot      = p
    ))
  })

  invisible(if (length(results) == 1L) results[[1L]] else results)
}

# ==========================================================================
# USAGE EXAMPLES
# ==========================================================================

# vector
# conjugate_normal_igamma(x = c(2.1,1.9,2.3,2.0), mu_known = 2,
#                         alpha = 3, beta = 1, cri_levels = c(90, 95))

# df + var
# df <- data.frame(measure = c(2.1,1.9,2.3,2.0,2.5,2.2,1.8,2.4))
# conjugate_normal_igamma(data = df, var = "measure", mu_known = 2,
#                         alpha = 3, beta = 1, cri_levels = c(90, 95),
#                         quantiles = c(0.01, 0.10))

conjugate_normal_igamma(x = c(2.1, 1.9, 2.3, 2.0), mu_known = 2,
                         alpha = 3, beta = 1, cri_levels = c(90, 95))
The output can be stored as an R object, allowing users to further enhance and customize the generated plots using the extensive capabilities of ggplot2, including options such as theme(), labs(), and other graphical modifications.
The provided script generates and displays a basic ggplot object on screen, which can be subsequently modified according to the desired presentation style, formatting preferences, or reporting requirements.
Sample Outputs
out1=conjugate_binomial_beta(x = 14, n = 20, alpha = 2, beta = 2, cri_levels = c(80, 90, 95, 99),quantiles = c(0.75))
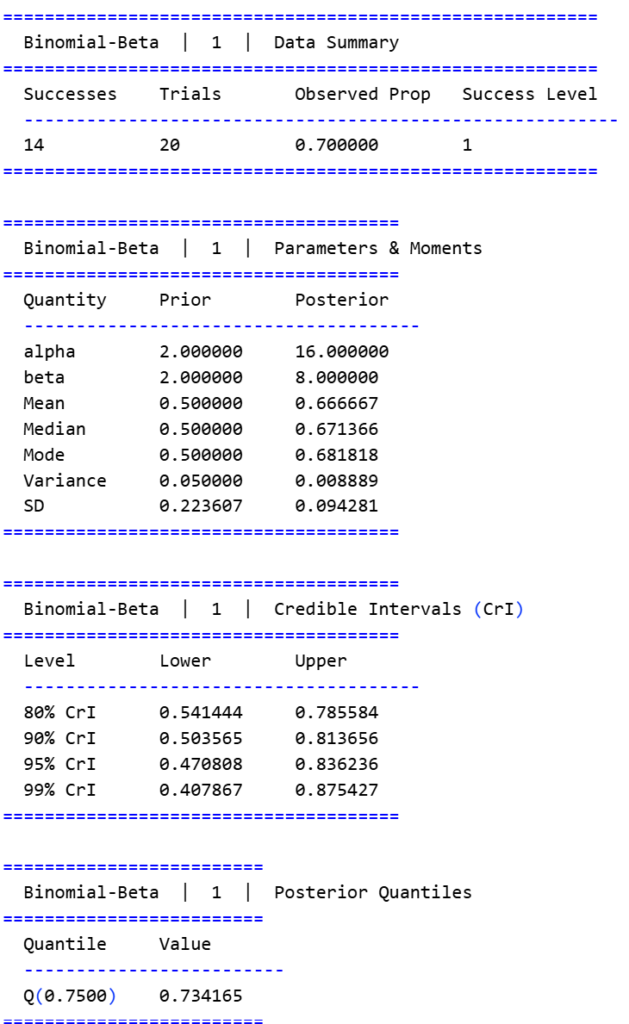
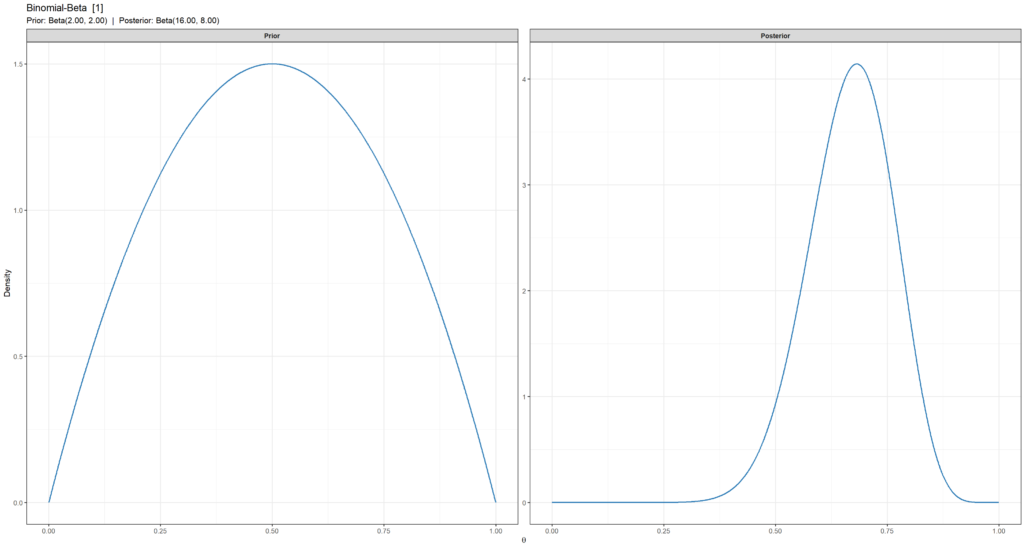
out1$plot is the ggplot object so as to enhance its properties